Billete abierto
 +373 79 600002
 Chat en directo de Telegram
 F.A.Q
 Español
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Português
 Українська
 български
 Polski
 Indonesia
 中文 (中国)



 en todos los servicios de hosting


¿Qué es Jev? El Modelo de Decisión de TypeSafe AI Explicado
Jev en Un Minuto: Decisiones de IA, No Otro Chatbot
Un cliente dice que su renovación de suscripción aparece dos veces y solicita un reembolso. Tu aplicación de soporte necesita un departamento y una bandera de solicitud de reembolso, no un ensayo. Jev de TypeSafe AI es un modelo de decisión que interpreta la información suministrada y devuelve respuestas de un conjunto que defines. Funciona dentro de una aplicación, no como un agente de soporte autónomo.
Piensa en un escritorio de clasificación con bandejas de departamento predefinidas y una tarjeta de calificación. Jev elige una bandeja, califica el mensaje contra niveles descritos y devuelve probabilidades junto con sus juicios. No compone respuestas ni escribe código. El escritorio aún puede poner un mensaje en la bandeja incorrecta: restringir las respuestas posibles no hace que cada respuesta sea correcta. Tu aplicación controla el siguiente paso, incluida la revisión humana.
TypeSafe anunció Jev en acceso temprano público el 15 de septiembre de 2026. Su lanzamiento atrajo atención al proponer un lugar diferente para la IA: decisiones de software cotidiano en lugar de otra ventana de chat. Evaluar esa promesa significa separar cargas de trabajo útiles de números titulares—y alojar tu aplicación desde alojar Jev mismo.
Cómo Jev Difiere de un LLM—y de las Reglas Ordinarias
El código puede verificar si una transacción se liquidó o si una cuenta tiene permiso. Interpretar “por favor devuelve el pago extra” requiere juicio semántico: entender el significado en lugar de verificar una condición exacta. Un modelo de lenguaje grande (LLM) puede generar texto, código y respuestas estructuradas, incluidas clasificaciones. Jev se enfoca en preguntas como qué departamento debe recibir un mensaje. Su salida tipificada utiliza un tipo de respuesta acordado y valores permitidos. Eso fija la forma de la etiqueta, no si se ajusta al mensaje.
Por ejemplo: Un cliente escribe, “Me cobraste dos veces. Por favor devuelve el pago extra.” El código verifica si dos cargos se liquidaron. Jev podría enrutar el mensaje a facturación desde los departamentos permitidos: facturación, técnico o cuenta. Un LLM podría redactar una respuesta.
| Enfoque | Trabajo principal | Salida | Mejor opción |
|---|---|---|---|
| Reglas ordinarias | Evaluar condiciones exactas establecidas sin interpretar la intención | Valores calculados o ramas de código predefinidas | Aritmética, permisos y lógica empresarial conocida |
| LLM generativo | Escritura y razonamiento flexible; también clasificación | Texto generado o resultados estructurados restringidos por esquema | Tareas abiertas, redacción, generación de código y razonamiento extendido |
| Jev | Interpretar información suministrada utilizando descripciones de respuestas permitidas | Opción, Puntuación o probabilidad de sí | Juicios repetidos donde las respuestas posibles pueden definirse de antemano |
Los LLM modernos pueden clasificar y adherirse a esquemas de salida compatibles. Los clasificadores tradicionales específicos de tareas ya manejan muchos trabajos de etiqueta fija. La propuesta de Jev es la especialización y preguntas configurables en lenguaje natural, no la invención de clasificación o propiedad exclusiva de respuestas estructuradas. Describes el juicio con palabras en lugar de entrenar un clasificador separado para cada nueva pregunta.
TypeSafe llama a esto un modelo “Sistema Uno”, inspirado en el juicio rápido e intuitivo. Esta es su terminología, no una categoría científica independiente o evidencia de cognición humana. TypeSafe dice que su método de entrenamiento, Reinforcement Learning for Calibrated Decisions (RLCD), tiene como objetivo hacer que las probabilidades asignadas reflejen resultados e incertidumbre. Ese objetivo no establece confiabilidad en todas las cargas de trabajo.
Cómo funciona Jev: Contexto dentro, tres tipos de respuesta fuera

Una interfaz de programación de aplicaciones (API) permite que el código de la aplicación envíe solicitudes y reciba respuestas. Con Jev, la aplicación proporciona estado—información sobre la situación—y preguntas. El estado no es memoria persistente: Jev no navega, no obtiene registros de facturación ni recuerda automáticamente solicitudes anteriores.
Considera este mensaje inventado: “Mi renovación de suscripción aparece dos veces en mi extracto de tarjeta. Por favor, devuelve el pago extra. Me molesta tener que hacer seguimiento nuevamente, pero agradecería tu ayuda.” El cargo sigue siendo un reclamo del cliente. Los criterios definen las categorías o niveles descriptivos utilizados para juzgarlo. Los tres primitivos de Jev, o pequeños bloques de construcción, cubren estos tipos de preguntas:
| Tipo de pregunta | Pregunta y respuestas permitidas | Lo que regresa |
|---|---|---|
| Opción | ¿Qué departamento? Facturación: cargos/reembolsos/suscripciones; técnico: características rotas; cuenta: inicio de sesión/perfil/acceso | Opción seleccionada, probabilidades para cada opción y confianza |
| Puntuación | ¿Frustración expresada? 0: neutral, sin molestia; 1: molesto pero constructivo; 2: lenguaje hostil o amenaza de cancelación | Una puntuación de 0–2 calculada a partir de las probabilidades de nivel, más una leyenda de nivel, probabilidades y confianza |
| Noul (nombre de la API para una probabilidad sí/no) | ¿Solicita explícitamente devolución de dinero o crédito de cuenta? Un reclamo de facturación solo no califica | Probabilidad de sí de 0 a 1; sin campo de confianza nativo separado |
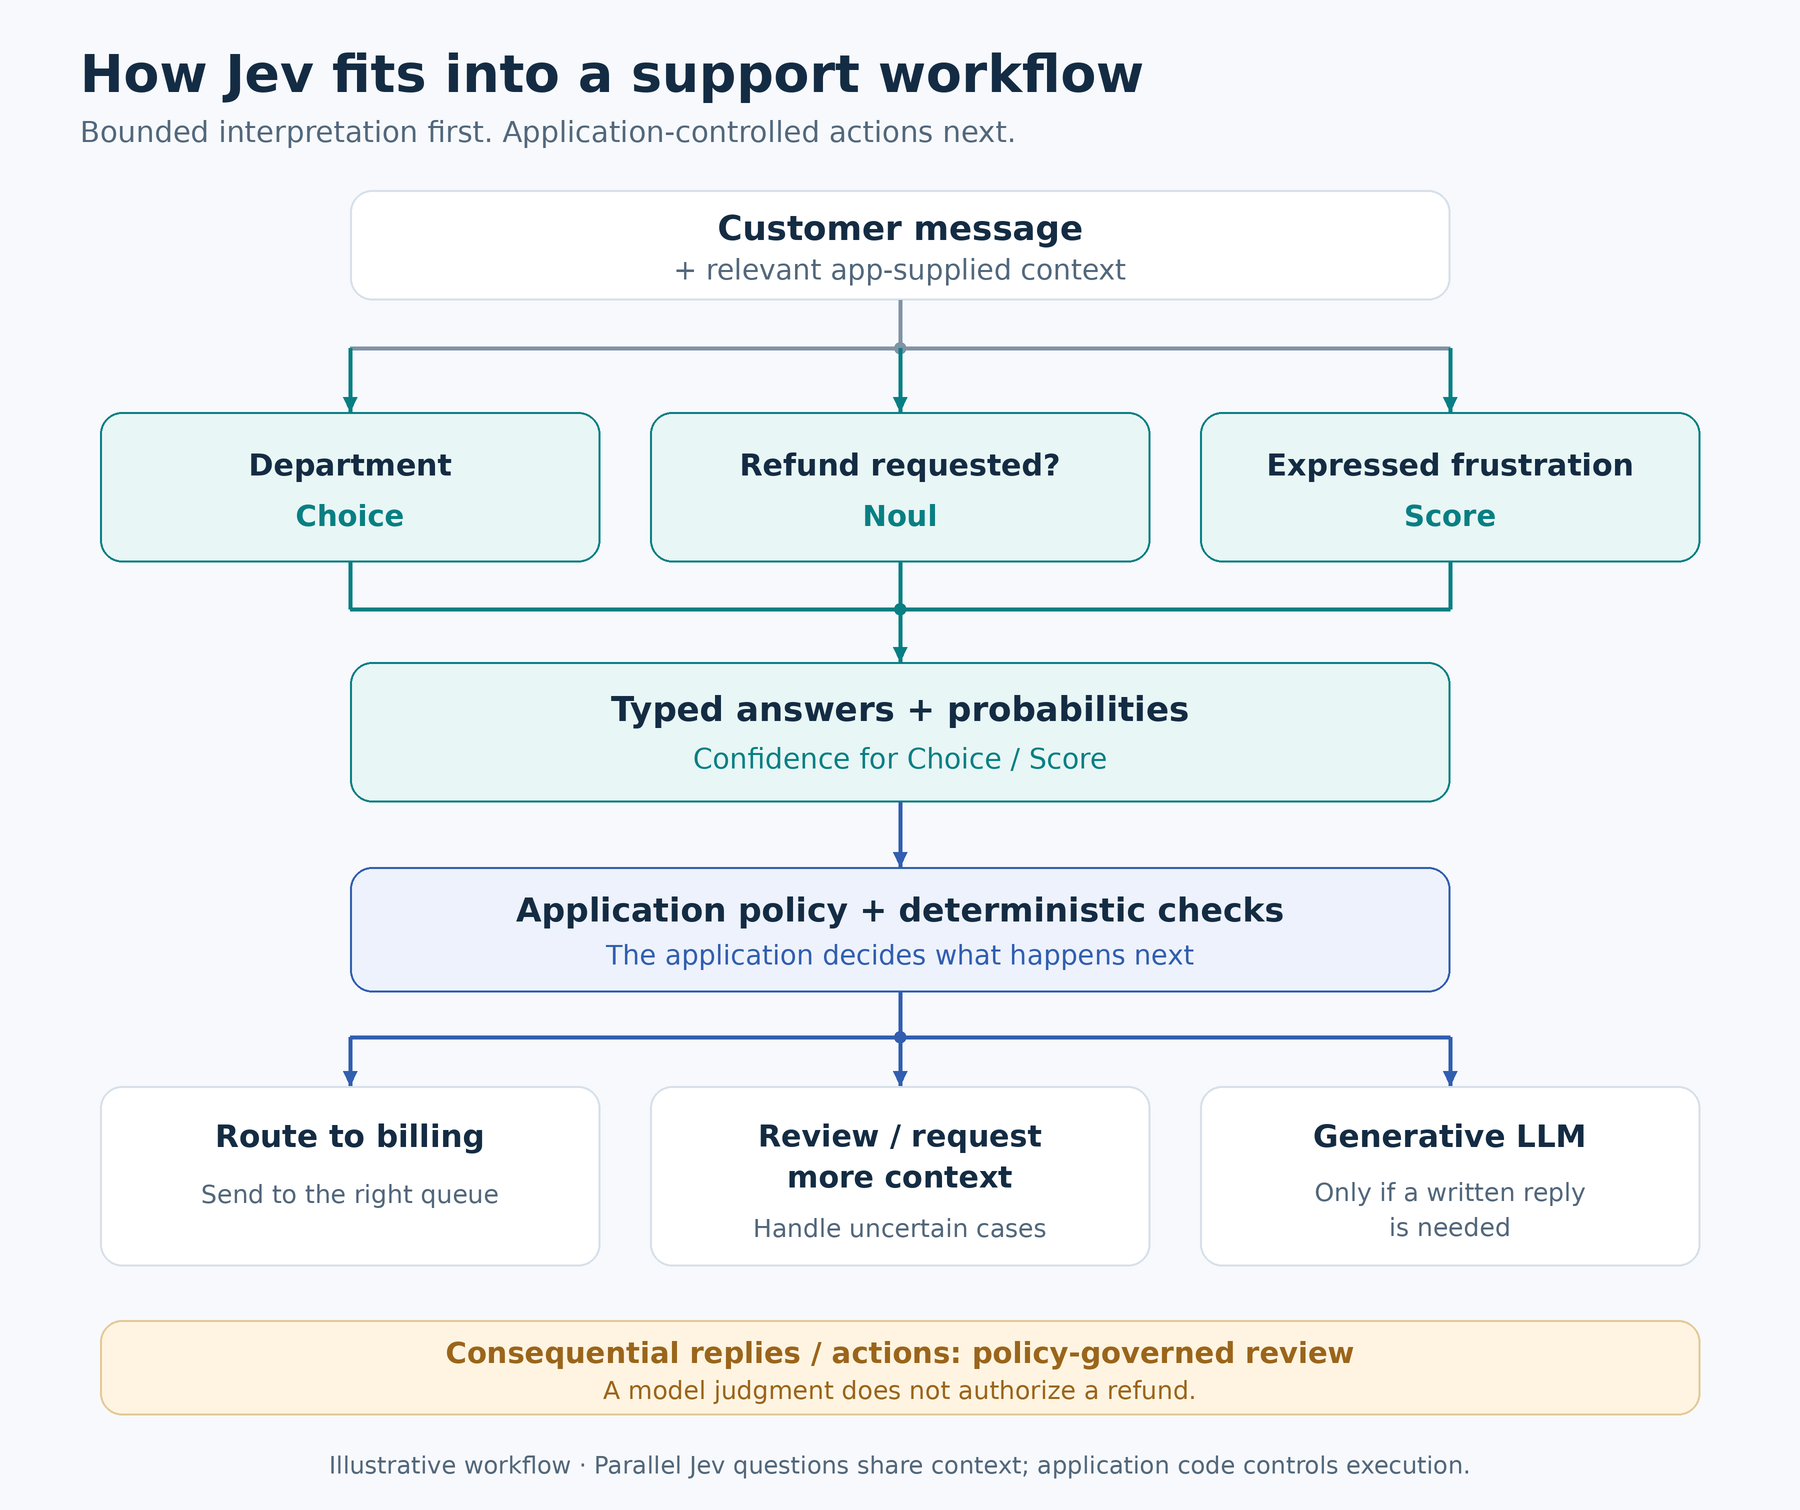
Los tres reciben el mismo contexto suministrado. La aplicación luego combina sus resultados y envía casos inciertos para revisión; el borrador de respuestas se maneja por separado. Las preguntas se ejecutan en paralelo contra estado compartido; ninguna lee la respuesta de otra en esa llamada. Esto no hace que las propiedades del cliente o los errores de predicción sean estadísticamente independientes. Una Puntuación puede caer entre niveles porque promedia sus números usando sus probabilidades. Aquí describe frustración expresada—no urgencia, valor de transacción o elegibilidad de reembolso.
Si una respuesta determina qué registros recuperar u opciones ofrecer a continuación, la pregunta dependiente requiere una solicitud posterior. Las preguntas adicionales aumentan la entrada facturable. Cada solicitud también tiene un límite en cuánto texto puede aceptar, por lo que no puedes seguir agregando preguntas indefinidamente. Las listas de departamentos reales también necesitan una ruta de otro/ninguno o revisión para mensajes fuera de estas tres categorías.
Lo que realmente puedes hacer con Jev
En el flujo de trabajo de soporte, una etiqueta de facturación podría enviar el mensaje a la cola correcta, mientras que una bandera de solicitud de reembolso le dice al personal qué quiere el cliente. La calificación de frustración podría ayudar a priorizar el seguimiento o la revisión humana junto con otros detalles del ticket. Estos son usos ilustrativos, no resultados observados de Jev; la urgencia y el impacto financiero necesitan su propia evidencia.
La investigación de facturación sigue un camino diferente: la aplicación recupera registros de pago autorizados y verifica si hay un cargo liquidado duplicado. La ejecución del reembolso debe satisfacer controles de política exactos y verificar la identidad y autorización, con la aprobación apropiada. Una predicción fuerte del modelo no cambia esos requisitos. La redacción de respuestas pertenece a un componente separado. Un cliente civil puede tener derecho a un reembolso, y un cliente enojado puede estar equivocado. El sentimiento se mantiene fuera de las verificaciones de elegibilidad. Otros flujos de trabajo controlados por código dividen el trabajo de manera similar:
| Flujo de trabajo | Lo que Jev decide | Lo que se mantiene fuera de Jev |
|---|---|---|
| Enrutamiento de modelo/herramienta | Elegir entre opciones nombradas usando la solicitud suministrada y criterios de selección | El código invoca el servicio seleccionado, valida argumentos y maneja opciones de reserva o no disponibles |
| Reordenamiento de pasajes | Calificar la relevancia de pasajes ya recuperados para que los candidatos puedan ser reordenados | La recuperación proporciona candidatos; el código los ordena; otro componente escribe y verifica la respuesta |
| Extracción/etiquetado acotado | Elegir una etiqueta de documento o valor de campo candidato coincidente, incluyendo “no indicado” | Un analizador u otro modelo encuentra valores candidatos; el código valida y ensambla el registro |
| Revisión de acción/alerta de texto | Señalar un significado de riesgo indicado o preocupación de política en descripciones de acciones o alertas suministradas | Los permisos, el aislamiento, las verificaciones exactas y la revisión humana/seguridad permanecen como controles separados |
Para las empresas, los ahorros potenciales provienen de reducir la clasificación repetitiva, pero Jev no es un gestor de operaciones sin código listo para usar. Un propietario de integración debe definir categorías y etiquetar ejemplos representativos. Esos ejemplos ayudan a medir si los errores y el trabajo de revisión superan los ahorros. Las reglas confiables existentes siguen siendo útiles; la oportunidad está en los mensajes que esas reglas no pueden interpretar bien.
Los auto-alojadores podrían agregar interpretación a un flujo de trabajo de mesa de ayuda, cola o documento existente sin ser propietarios del modelo localmente. La revisión de seguridad es una revisión complementaria: no reemplaza un firewall o antivirus. Tampoco es un detector de ataque completo o un límite para otorgar autorización. La limitación de contenido adversarial documentada de TypeSafe significa que el texto malicioso también puede influir en este revisor. Una preocupación señalada invita a la investigación; una entrada sin señalar no es un certificado de seguridad.
Por qué el lanzamiento atrajo atención—y cómo leer los números
Los números de Jev son una razón para evaluarlo, no un pronóstico para tu aplicación. En clasificación de alto volumen y enrutamiento interactivo, los pequeños costos y retrasos se acumulan. Los juicios paralelos, los precios de entrada bajos y sin cargo por token de salida explican su atractivo. La discusión de integración de LangChain y el informe de implementación de Browserbase muestran interés de desarrolladores, no adopción universal o madurez de producción.
En su evidencia de lanzamiento, TypeSafe reporta respuestas de extremo a extremo de 70–500 ms y comparaciones de flujo de trabajo aproximadamente 194× más rápidas y 445× más baratas. Describe las ganancias principales como hacia el extremo superior de las mejoras esperadas en el mundo real. No son multiplicadores universales ni una garantía de nivel de servicio.
TypeSafe construyó sus propios flujos de trabajo de prueba, utilizando probabilidades de otros modelos en lugar de verdad fundamental factual etiquetada independientemente.
- Las pruebas de la Costa Oeste, entradas de demostración cortas que favorecieron a Jev, y los ajustes y envoltorios de comparación también limitan cuán ampliamente se aplican los resultados.
- El informe del 21 de septiembre de Browserbase ofrece un ejemplo híbrido concreto: la latencia mediana inicial de Stagehand Act cayó de 1.97 a 0.46 segundos—aproximadamente 4.3× más rápido—con Jev seleccionando candidatos acotados, Stagehand ejecutando en código, y un LLM manejando el fallback. Este resultado reportado por el implementador no es un benchmark reproducido independientemente o de propósito general.
📝 Nota — el precio de entrada no es el costo total del sistema: Según se verificó el 5 de octubre de 2026, TypeSafe lista jev-1.13.0 a $0.042 por millón de tokens de entrada, sin cargo por token de salida. Los tokens son fragmentos de texto—no solicitudes o recuentos exactos de palabras—e la entrada facturable incluye estado y preguntas.
Hipotéticamente, 100,000 solicitudes × 1,000 tokens de entrada = 100 millones de tokens, costando $4.20. Los reintentos, otras llamadas de modelo, hosting, ingeniería y revisión humana añaden costos. Los juicios repetitivos pueden ser económicos si la calidad y las tasas de fallback son aceptables; este ejemplo no es ni una cotización de sistema completo ni un retorno garantizado.
Lo que las Probabilidades y la Confianza Realmente te Dicen
- Probability expresa qué tan probable considera el modelo una respuesta: facturación en lugar de soporte técnico, o sí a la pregunta de solicitud de reembolso.
- Calibration describe cómo esas estimaciones coinciden con los resultados en predicciones representativas.
Para un pronóstico de lluvia calibrado al 80%, la lluvia debería ocurrir en aproximadamente el 80% de ocasiones comparables asignadas a esa probabilidad. Del mismo modo, aproximadamente el 80% de las etiquetas predichas en ese grupo de probabilidad deberían ser correctas—no necesariamente ninguna etiqueta en particular. TypeSafe describe entrenamiento orientado a calibración; tu carga de trabajo aún necesita validación.
Choice y Score también devuelven confidence, una estadística derivada de cómo se distribuye la probabilidad entre las respuestas. Un Choice ilustrativo—no medido—de tres opciones con una probabilidad superior de 0.90 tiene confianza 0.85 bajo la regla documentada actual. El primero estima qué tan probable es la respuesta; el segundo muestra qué tan claramente supera las alternativas. Confidence no es una verificación de hechos separada ni una probabilidad del 85% de corrección.
Un Score describe la posición en tu escala: la baja frustración puede predecirse con alta confianza. Una puntuación media puede reflejar probabilidad concentrada en el medio o dividida entre extremos opuestos, así que inspecciona la distribución. Noul cerca de 0.5 significa ambigüedad sí/no, no frustración media. Su probabilidad de sí lleva la incertidumbre; no hay un campo de confianza nativo.
Advertencia — valida antes de automatizar: Un punto de corte copiado de otra carga de trabajo puede no ser adecuado para tus mensajes. Usa ejemplos representativos con etiquetas conocidas para verificar tanto errores de predicción como con qué frecuencia los casos necesitan revisión o alternativa.
Usa esos resultados para decidir qué mensajes pueden enrutarse automáticamente, cuáles necesitan confirmación y cuáles requieren revisión humana. El punto de corte debe reflejar las consecuencias de un error: enrutar incorrectamente un ticket reversible difiere de autorizar un pago. Esto hace que confidence sea útil como señal de enrutamiento, con el umbral elegido para tu tarea en lugar de tratarse como un número universal.
Lo que Jev no puede hacer—y lo que la publicidad omite
La afirmación de TypeSafe de “no puede alucinar” describe el formato de salida. Para confiabilidad práctica, las preguntas relevantes son dónde Jev tiene dificultades y cómo aparecen los fallos. Una predicción incorrecta requiere una respuesta diferente a una solicitud API fallida. Si la predicción fue correcta, un fallo puede estar en cómo la lógica de la aplicación la utilizó.
La interfaz restringida también descarta pedir a Jev prosa, código o una explicación de su razonamiento. Para esas salidas, usa un LLM generativo. En el lado de entrada, Jev acepta texto, incluidas estructuras JSON compatibles—no imágenes, audio o video directos. Trabajar con medios requiere un servicio de preprocesamiento separado para proporcionar texto o campos estructurados.
La aritmética exacta, el conteo y las comparaciones de fechas pertenecen al código. Los juicios multi-salto extendidos también son un mal ajuste. Para extracción, Jev selecciona candidatos o componentes que suministras; no genera libremente cadenas arbitrarias ni reconstruye un monto de reembolso a partir de una Puntuación. Las limitaciones de TypeSafe Jev 1.13, revisadas el 2 de octubre de 2026, agrupan varias otras debilidades prácticas:
- Redacción y criterios: Las lecturas literales, la indirección y los criterios contradictorios pueden engañar al modelo. Usa preguntas estrechas y explícitas con descripciones alineadas.
- Contexto: El estado irrelevante puede distraerlo. Recupera y filtra primero en lugar de enviar cada registro disponible.
- Entradas y opciones: El texto adversarial y el orden de opciones pueden afectar las respuestas. Prueba entradas maliciosas y opciones reordenadas; estas pruebas no confieren inmunidad.
La documentación actual del modelo dice que el inglés funciona mejor; evalúa otros idiomas en tu propio contenido. También enumera límites de contexto exactos: la capacidad es limitada, y una ventana grande no garantiza atención perfecta. Los alias de versión pueden cambiar sin un cambio de aplicación, así que reevalúa umbrales ajustados cuando las versiones cambien. El entrenamiento de modelo adicional específico del cliente no se ofrece actualmente; das forma al comportamiento del dominio a través del contexto y los criterios de pregunta.
¿Puedes auto-alojar Jev? Dónde encaja un VPS
Inference significa ejecutar un modelo para responder a una solicitud. Según se verificó el 5 de octubre, la oferta pública documentada sirve inferencia Jev a través de la API de TypeSafe. Los documentos revisados no proporcionan ni pesos de modelo descargables públicamente ni una ruta de implementación local estándar. El código de integración abierto no es pesos de modelo abiertos: puedes auto-alojar la aplicación, pero Jev permanece externo.
Un VPS, o servidor privado virtual, puede alojar la aplicación circundante. Un VPS de AlexHost de tamaño apropiado puede ejecutar el backend o workers que llaman a Jev. También puede alojar la cola de la aplicación, la base de datos o la interfaz de revisión. El acceso al modelo y los cargos de API son separados. No necesitas ni una compra de servidor ni una GPU para probar el servicio alojado; dimensiona el alojamiento para el tráfico de la aplicación y las cargas de trabajo locales, no para la inferencia Jev.
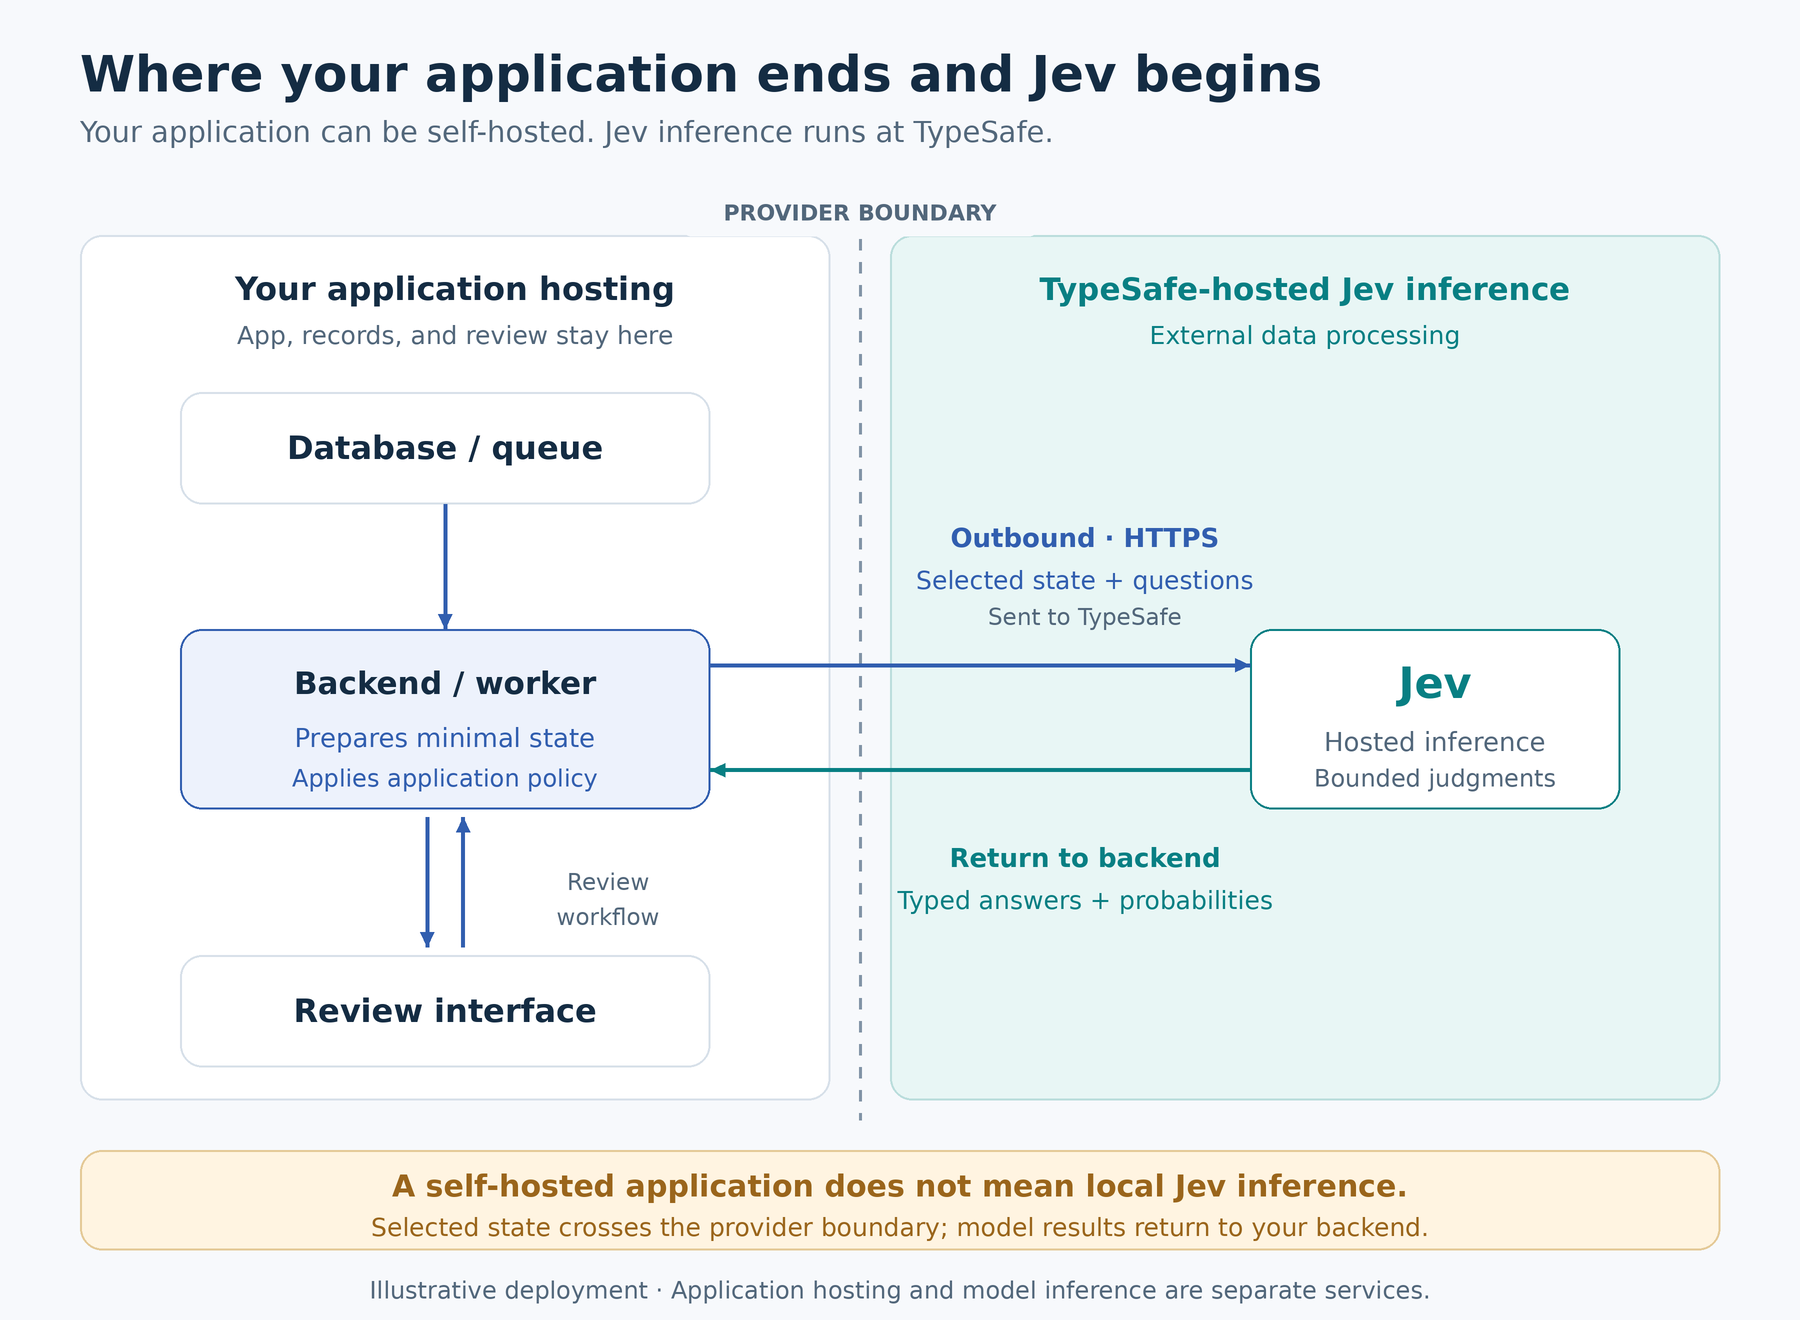
La aplicación, los registros y la interfaz de revisión pueden ejecutarse en tu servidor, mientras que el contexto seleccionado se cruza a TypeSafe para inferencia y las decisiones regresan al backend.
Advertencia — una aplicación auto-alojada no significa inferencia local: El estado seleccionado sale de tu límite de alojamiento. Los compromisos sin entrenamiento no implican retención cero por defecto. Verifica los términos del proveedor aplicables antes de enviar información sensible a través de este flujo de trabajo.
La política de privacidad de TypeSafe descarta el entrenamiento o ajuste fino en las entradas. También describe alojamiento en EE.UU. y permite retención según sea razonablemente necesario. Su descripción legal ofrece retención cero de datos (ZDR) empresarial sujeto a términos aplicables. Para flujos de trabajo de datos personales, el acuerdo de procesamiento de datos aborda el procesamiento y las transferencias internacionales; la ubicación del servidor es solo parte de la decisión.
Envía solo el contexto necesario para la decisión, dejando fuera secretos y datos personales innecesarios. Protege las claves del proveedor y mantén los controles de acceso en su lugar. Mantén un fallback de límite de tiempo/velocidad, como poner en cola para revisión; maneja las solicitudes fallidas por separado de las respuestas inciertas. Como operador de la aplicación, sigues siendo responsable de aplicar parches y monitorear. Las copias de seguridad y la política de flujo de trabajo también dependen de ti.
¿Quién debería considerar Jev—y quién debería omitirlo?
Jev incorpora juicio semántico en software a través de preguntas con respuestas predefinidas.
- Puede enrutar un mensaje de cliente
- Calificar la relevancia de un pasaje
- Estimar si una solicitud cumple con criterios establecidos, devolviendo resultados tipados y probabilidades que el código de aplicación puede usar.
Su atractivo radica en hacer estas decisiones repetidas rápidas y económicas. El valor práctico aún depende de criterios claros, contexto relevante y desempeño en tus propios ejemplos. Las respuestas limitadas pueden ser incorrectas, y las probabilidades ayudan a guiar la revisión en lugar de garantizar la corrección.
Para el cliente que pide “devolver el pago extra,” el rol de Jev es reconocer la solicitud y ayudar a enviarla al lugar correcto. Los registros, permisos y ejecución de reembolsos permanecen con la aplicación. Comienza con un flujo de trabajo pequeño y revisable usando la API alojada, luego mide la precisión, necesidades de respaldo y costo total. Ahí es donde la promesa de Jev se vuelve concreta: juicio útil conectado a un paso siguiente bien definido.