Відкритий квиток
 +373 79 600002
 Telegram Онлайн-чат
 Часті запитання
 Українська
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Español
 Português
 български
 Polski
 Indonesia
 中文 (中国)



 на всіх хостингових послугах


Що таке Jev? Пояснення моделі прийняття рішень TypeSafe AI
Jev за хвилину: AI рішення, а не ще один чатбот
Клієнт каже, що його поновлення підписки з’являється двічі, і просить повернути гроші. Ваша програма підтримки потребує відділу та прапора запиту на повернення, а не есе. Jev від TypeSafe AI — це модель рішень, яка інтерпретує надану інформацію та повертає відповіді з набору, який ви визначаєте. Вона працює всередині програми, а не як автономний агент підтримки.
Уявіть сортувальний стіл з попередньо визначеними лотками відділів та карткою оцінки. Jev вибирає лоток, оцінює повідомлення за описаними рівнями та повертає ймовірності разом зі своїми судженнями. Вона не складає відповіді та не пише код. Стіл все ще може помилитися і покласти повідомлення в неправильний лоток: обмеження можливих відповідей не робить кожну відповідь правильною. Ваша програма контролює наступний крок, включаючи людський огляд.
TypeSafe оголосила Jev у відкритому ранньому доступі 15 вересня 2026 року. Її запуск привернув увагу, запропонувавши інше місце для AI: повсякденні рішення програмного забезпечення, а не ще одне вікно чату. Оцінка цієї обіцянки означає розділення корисних робочих навантажень від цифр у заголовках — і розміщення вашої програми окремо від розміщення самого Jev.
Як Jev відрізняється від LLM—і від звичайних правил
Код може перевірити, чи розраховується транзакція або чи має обліковий запис дозвіл. Інтерпретація “будь ласка, поверніть додатковий платіж” вимагає семантичного судження: розуміння значення, а не перевірки точної умови. Велика мовна модель (LLM) може генерувати текст, код і структуровані відповіді, включаючи класифікації. Jev зосереджується на питаннях, таких як який відділ повинен отримати повідомлення. Його типізований вихід використовує узгоджений тип відповіді та дозволені значення. Це фіксує форму мітки, а не те, чи вона підходить до повідомлення.
Наприклад: Клієнт пише: “Ви мене зарядили двічі. Будь ласка, поверніть додатковий платіж.” Код перевіряє, чи розраховані два платежі. Jev міг би маршрутизувати повідомлення до billing з дозволених відділів: billing, technical або account. LLM міг би підготувати відповідь.
| Підхід | Основна робота | Вихід | Найкраще підходить для |
|---|---|---|---|
| Звичайні правила | Оцінка точно вказаних умов без інтерпретації наміру | Обчислені значення або попередньо визначені гілки коду | Арифметика, дозволи та відома бізнес-логіка |
| Генеративна LLM | Написання та гнучке міркування; також класифікація | Згенерований текст або структуровані результати, обмежені схемою | Відкриті завдання, чернетки, генерація коду та розширене міркування |
| Jev | Інтерпретація наданої інформації за допомогою описів дозволених відповідей | Вибір, оцінка або ймовірність “так” | Повторювані судження, де можливі відповіді можна визначити заздалегідь |
Сучасні LLM можуть класифікувати та дотримуватися підтримуваних схем виходу. Традиційні класифікатори, специфічні для завдань, вже обробляють багато завдань з фіксованими мітками. Пропозиція Jev полягає в спеціалізації та питаннях, які можна налаштувати природною мовою, а не в винаході класифікації або виключному володінні структурованими відповідями. Ви описуєте судження словами, а не навчаєте окремий класифікатор для кожного нового питання.
TypeSafe називає це моделлю “System One”, натхненною швидким, інтуїтивним судженням. Це їхня термінологія, а не незалежна наукова категорія або доказ людського пізнання. TypeSafe стверджує, що його метод навчання, Reinforcement Learning for Calibrated Decisions (RLCD), спрямований на те, щоб призначені ймовірності відображали результати та невизначеність. Ця мета не встановлює надійність для кожного навантаження.
Як працює Jev: контекст на вході, три типи відповідей на виході

Інтерфейс програмування додатків (API) дозволяє коду додатка надсилати запити та отримувати відповіді. За допомогою Jev додаток надає стан—інформацію про ситуацію—та запитання. Стан не є постійною пам’яттю: Jev не переглядає, не отримує записи про виставлення рахунків та не запам’ятовує автоматично попередні запити.
Розглянемо це вигадане повідомлення: “Моє поновлення передплати з’являється двічі на виписці моєї карти. Будь ласка, поверніть додатковий платіж. Мене дратує, що мені доводиться робити повторний запит, але я вдячний за вашу допомогу.” Платіж залишається претензією клієнта. Критерії визначають категорії або описові рівні, які використовуються для оцінки. Три примітиви Jev, або невеликі будівельні блоки, охоплюють ці типи запитань:
| Тип запитання | Запитання та допустимі відповіді | Що повертається |
|---|---|---|
| Вибір | Який відділ? Виставлення рахунків: платежі/повернення/передплати; технічна підтримка: несправні функції; обліковий запис: вхід/профіль/доступ | Вибрана опція, ймовірності для кожної опції та впевненість |
| Оцінка | Виражена фрустрація? 0: нейтральна, без розчарування; 1: розчарована, але конструктивна; 2: ворожа формулювання або загроза скасування | Оцінка 0–2, розраховується з ймовірностей рівнів, плюс легенда рівнів, ймовірності та впевненість |
| Noul (назва API для ймовірності так/ні) | Явно просить повернення грошей або кредит на рахунок? Сама скарга на виставлення рахунків не кваліфікується | Ймовірність “так” від 0 до 1; немає окремого вбудованого поля впевненості |
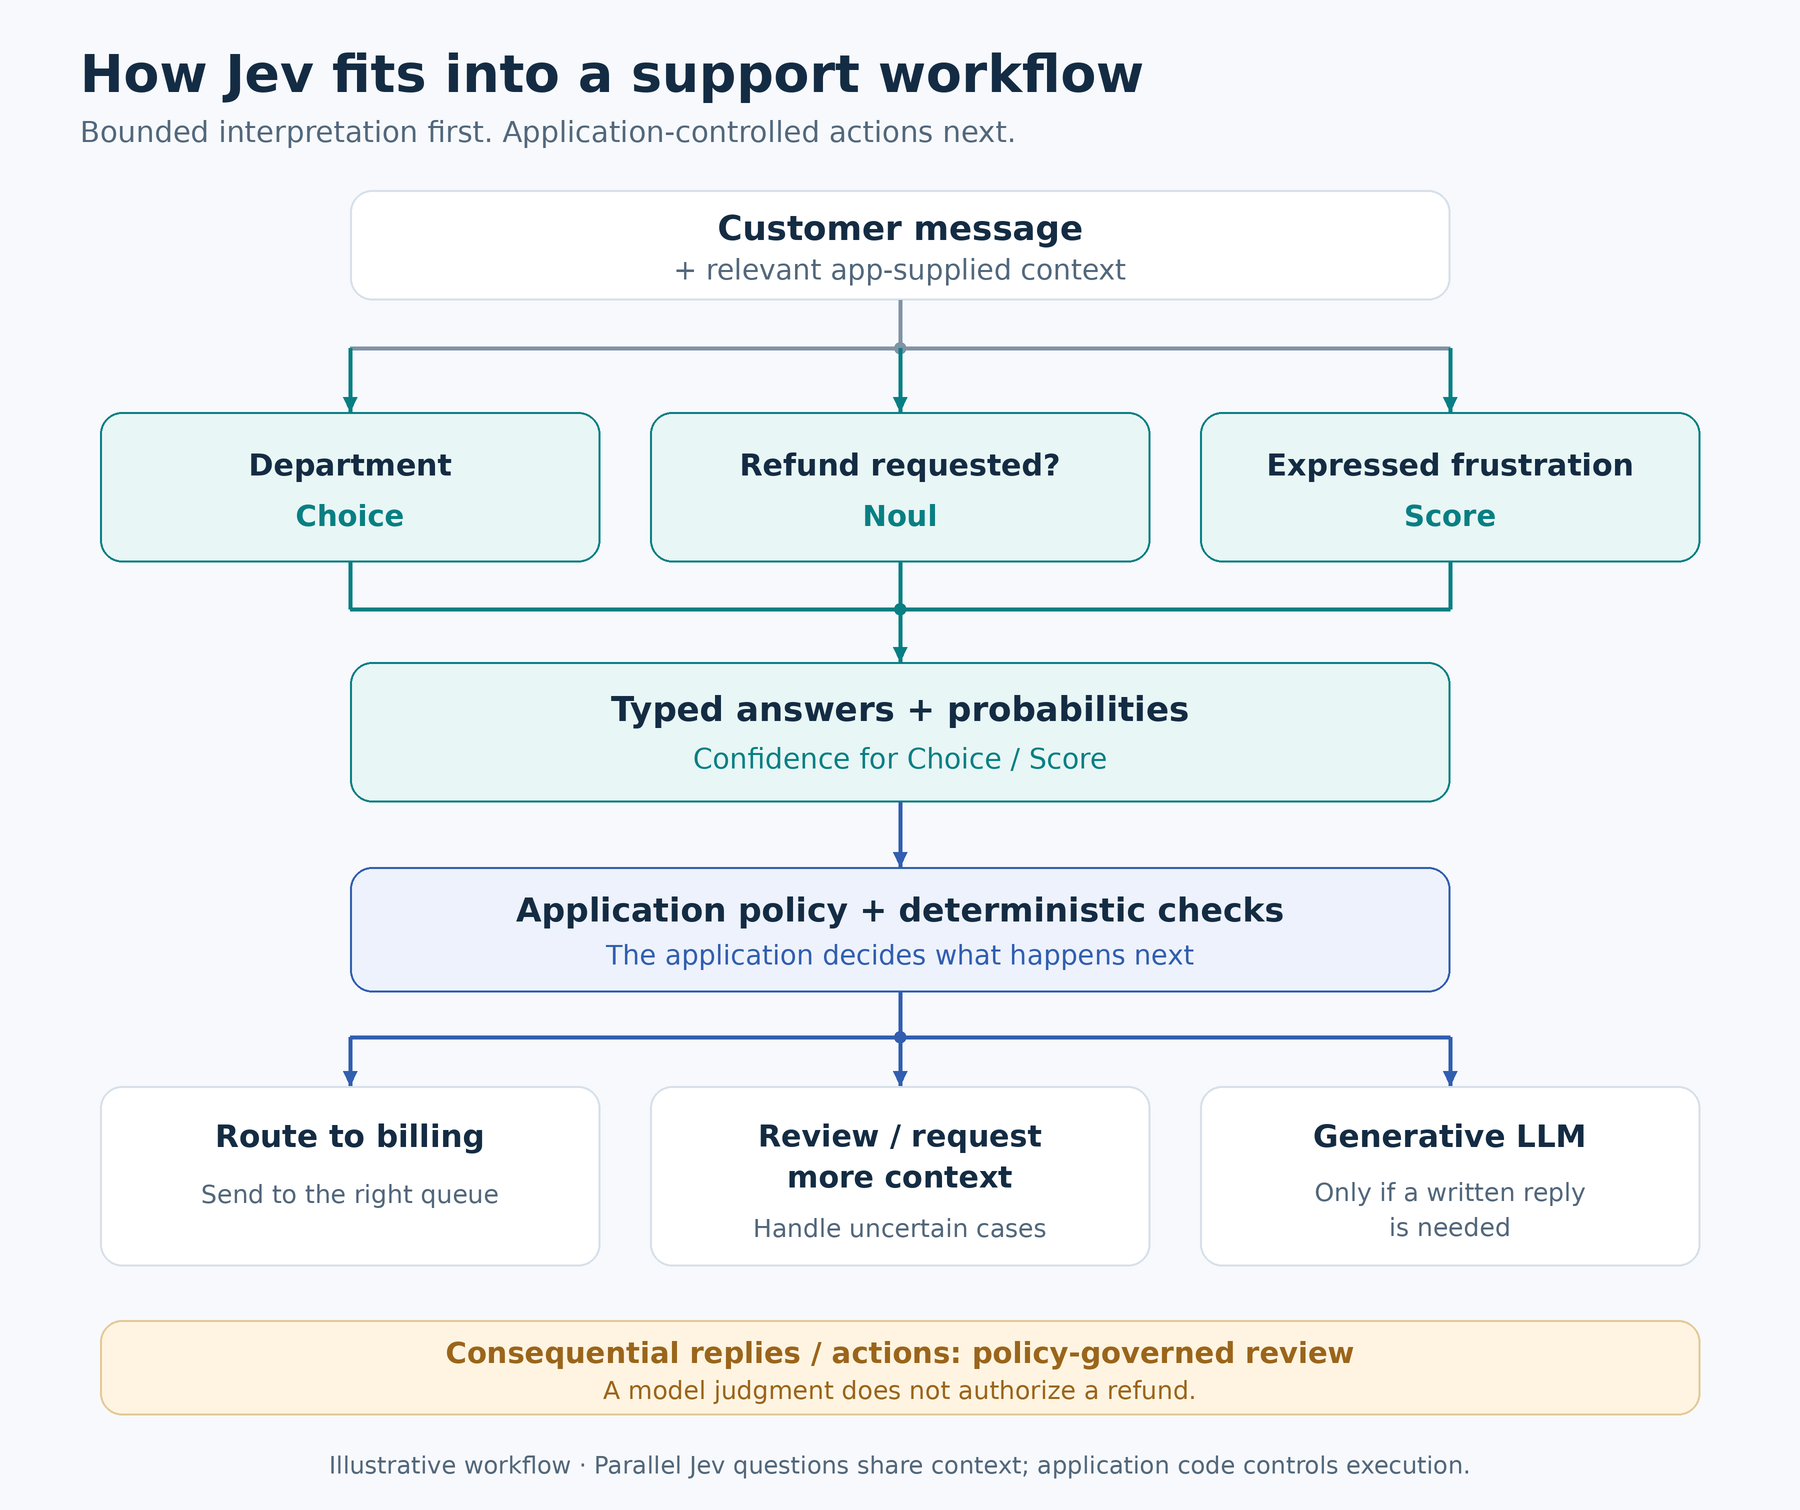
Усі три отримують один і той же надданий контекст. Додаток потім об’єднує їхні результати та надсилає невизначені випадки на перевірку; підготовка відповідей обробляється окремо. Запитання виконуються паралельно для спільного стану; жодне не читає відповідь іншого в цьому виклику. Це не робить властивості клієнта або помилки прогнозування статистично незалежними. Оцінка може падати між рівнями, тому що вона усереднює їхні числа, використовуючи їхні ймовірності. Тут вона описує виражену фрустрацію—не терміновість, вартість транзакції або право на повернення.
Якщо відповідь визначає, які записи отримати або які опції запропонувати далі, залежне запитання вимагає пізнішого запиту. Додаткові запитання збільшують платіжний вхід. Кожен запит також має обмеження на кількість тексту, який він може прийняти, тому ви не можете нескінченно додавати запитання. Реальні списки відділів також потребують шляху “інше/немає” або перевірки для повідомлень, які не входять до цих трьох категорій.
Що ви насправді можете робити з Jev
У робочому процесі підтримки мітка виставлення рахунків може відправити повідомлення до правильної черги, а прапор запиту на повернення коштів повідомляє персоналу, чого хоче клієнт. Рейтинг фрустрації може допомогти визначити пріоритет подальшого спілкування або перевірки людиною поряд з іншими деталями квитка. Це ілюстративні варіанти використання, а не спостережувані результати Jev; терміновість та фінансовий вплив потребують власних доказів.
Розслідування виставлення рахунків йде іншим шляхом: програма отримує авторитетні записи платежів і перевіряє наявність дублювання розраховуваного платежу. Виконання повернення коштів має задовольняти точні перевірки політики та перевірити особу та авторизацію з відповідним затвердженням. Сильне передбачення моделі не змінює ці вимоги. Складання відповіді належить до окремого компонента. Ввічливий клієнт може мати право на повернення коштів, а розлючений клієнт може помилятися. Настрій залишається поза перевірками прав. Інші керовані кодом робочі процеси розділяють роботу аналогічно:
| Робочий процес | Що вирішує Jev | Що залишається поза Jev |
|---|---|---|
| Маршрутизація моделі/інструменту | Вибір серед названих варіантів за допомогою наданого запиту та критеріїв вибору | Код викликає вибрану службу, перевіряє аргументи та обробляє резервні або недоступні варіанти |
| Переранжування уривків | Оцінка релевантності вже отриманих уривків, щоб кандидати могли бути переупорядковані | Пошук надає кандидатів; код впорядковує їх; інший компонент пише та перевіряє відповідь |
| Обмежена екстракція/маркування | Вибір мітки документа або відповідного значення поля кандидата, включаючи «не зазначено» | Парсер або інша модель знаходить значення кандидатів; код перевіряє та збирає запис |
| Перевірка дії/текстового сповіщення | Позначити зазначене ризиковане значення або проблему політики в наданих описах дій або сповіщеннях | Дозволи, пісочниця, точні перевірки та людська/безпекова перевірка залишаються окремими контролями |
Для бізнесу потенційна економія походить від скорочення повторюваного сортування, але Jev не є готовим до використання менеджером операцій без коду. Власник інтеграції повинен визначити категорії та позначити репрезентативні приклади. Ці приклади допомагають виміряти, чи перевищують помилки та робота перевірки економію. Існуючі надійні правила залишаються корисними; можливість полягає в повідомленнях, які ці правила не можуть добре інтерпретувати.
Самостійні хостери можуть додати інтерпретацію до існуючого робочого процесу служби підтримки, черги або документа без володіння моделлю локально. Перевірка безпеки є додатковою перевіркою: вона не замінює брандмауер або антивірус. Це також не є повним детектором атак або межею для надання авторизації. Задокументоване обмеження TypeSafe щодо змісту, який є противником, означає, що шкідливий текст також може вплинути на цього рецензента. Позначена проблема запрошує розслідування; невідмічений вхід не є сертифікатом безпеки.
Чому запуск привернув увагу—і як читати цифри
Цифри Jev є причиною для його оцінки, а не прогнозом для вашої програми. При великому обсязі сортування та інтерактивної маршрутизації невеликі витрати та затримки складаються. Паралельні судження, низька вхідна ціна та відсутність плати за вихідні токени пояснюють його привабливість. Обговорення інтеграції LangChain та звіт про впровадження Browserbase показують інтерес розробників, а не універсальне прийняття або готовність до виробництва.
У своїх доказах запуску TypeSafe повідомляє про 70–500 мс наскрізні відповіді та порівняння робочих процесів приблизно в 194× швидше та 445× дешевше. Він описує основні досягнення як на верхньому кінці очікуваних реальних поліпшень. Це не універсальні множники та не гарантія рівня обслуговування.
TypeSafe побудував власні тестові робочі процеси, використовуючи ймовірності інших моделей замість незалежно позначеної фактичної основи істини.
- Тестування на західному узбережжі, короткі демо-вводи, які сприяли Jev, та порівняльні обгортки та налаштування також обмежують, наскільки широко застосовуються результати.
- Звіт Browserbase від 21 вересня пропонує конкретний гібридний приклад: медіана затримки ранньої Stagehand Act впала з 1,97 до 0,46 секунди—приблизно в 4,3× швидше—з Jev вибором обмежених кандидатів, Stagehand виконанням у коді та LLM, що обробляє резервний варіант. Цей результат, повідомлений розробником, не є незалежно відтвореним або загального призначення тестом.
📝 Примітка — вхідна ціна не є загальною вартістю системи: Як перевірено 5 жовтня 2026 року, TypeSafe вказує jev-1.13.0 за $0.042 за мільйон вхідних токенів, без плати за вихідні токени. Токени — це фрагменти тексту—не запити або точні підрахунки слів—і платіжні вводи включають стан та питання.
Гіпотетично, 100 000 запитів × 1 000 вхідних токенів = 100 мільйонів токенів, що коштує $4.20. Повторні спроби, інші виклики моделей, хостинг, інженерія та людський огляд додають витрати. Повторювані судження можуть бути економічними, якщо якість та показники резервних варіантів прийнятні; цей приклад не є ні повною системною пропозицією, ні гарантованим повертанням.
Що насправді розповідають вам ймовірності та впевненість
- Ймовірність виражає, наскільки вірогідною модель вважає відповідь: біління замість технічної підтримки, або так на питання про повернення коштів.
- Калібрування описує, наскільки ці оцінки відповідають результатам у репрезентативних прогнозах.
Для каліброваного прогнозу дощу на 80%, дощ повинен йти приблизно на 80% порівнянних випадків, яким присвоєна така ймовірність. Аналогічно, приблизно 80% передбачених міток у цій групі ймовірності повинні бути правильними—не обов’язково якась конкретна мітка. TypeSafe описує навчання, орієнтоване на калібрування; ваше навантаження все ще потребує валідації.
Choice і Score також повертають впевненість, статистику, отриману з того, як ймовірність розподіляється між відповідями. Ілюстративний—не виміряний—Choice з трьома варіантами з найвищою ймовірністю 0.90 має впевненість 0.85 за поточним задокументованим правилом. Перший показує, наскільки вірогідна відповідь; другий показує, наскільки чітко вона перевершує альтернативи. Впевненість не є окремою перевіркою фактів або 85% ймовірністю правильності.
Score описує позицію на вашій шкалі: низьку фрустрацію можна передбачити з високою впевненістю. Середня оцінка може відображати ймовірність, зосереджену в середині або розділену між протилежними крайностями, тому перевірте розподіл. Noul близько 0.5 означає неоднозначність так/ні, а не середню фрустрацію. Її ймовірність «так» несе невизначеність; немає вбудованого поля впевненості.
Попередження — валідуйте перед автоматизацією: Поріг, скопійований з іншого навантаження, може не підходити для ваших повідомлень. Використовуйте репрезентативні приклади з відомими мітками, щоб перевірити як помилки прогнозування, так і те, як часто випадки потребують перевірки або резервного варіанту.
Використовуйте ці результати, щоб вирішити, які повідомлення можуть бути маршрутизовані автоматично, які потребують підтвердження, а які вимагають людського огляду. Поріг повинен відображати наслідки помилки: неправильна маршрутизація оборотного квитка відрізняється від авторизації платежу. Це робить впевненість корисною як сигнал маршрутизації, з порогом, вибраним для вашого завдання, а не розглядається як універсальне число.
Що Jev не може робити—і що залишається поза гайпом
Твердження TypeSafe про “неможливість галюцинацій” описує формат виходу. Для практичної надійності релевантні питання полягають у тому, де Jev відстає і як виявляються збої. Неправильне передбачення потребує іншої відповіді, ніж невдалий запит API. Якщо передбачення було правильним, збій може лежати в тому, як логіка додатка його використала.
Обмежений інтерфейс також виключає можливість запитувати у Jev прозу, код або пояснення його міркувань. Для цих виходів використовуйте генеративну LLM. На стороні входу Jev приймає текст, включаючи підтримувані структури JSON—не прямі зображення, аудіо чи відео. Робота з медіа потребує окремого сервісу попередньої обробки для надання тексту або структурованих полів.
Точна арифметика, підрахунок і порівняння дат належать до коду. Розширені багатоступеневі судження також погано підходять. Для видобування Jev вибирає кандидатів або компоненти, які ви надаєте; він не генерує вільно довільні рядки і не реконструює суму повернення з Score. Обмеження TypeSafe Jev 1.13, переглянуті 2 жовтня 2026 року, групують кілька інших практичних слабкостей:
- Формулювання та критерії: Буквальні прочитання, непрямість та суперечливі критерії можуть ввести модель в оману. Використовуйте вузькі, явні питання з узгодженими описами.
- Контекст: Нерелевантний стан може відволікти його. Спочатку отримайте та відфільтруйте, а не надсилайте кожен доступний запис.
- Входи та опції: Ворожий текст і порядок опцій можуть вплинути на відповіді. Протестуйте шкідливі входи та переупорядковані опції; ці тести не дають імунітету.
Поточна документація моделі говорить, що англійська мова працює найкраще; оцініть інші мови на своєму вмісті. Вона також наводить точні обмеження контексту: потужність обмежена, і великий контекст не гарантує ідеальної уваги. Псевдоніми версій можуть змінюватися без змін додатка, тому переоцініть налаштовані пороги при зміні версій. Додаткове навчання моделі, специфічне для клієнта, наразі не пропонується; ви формуєте поведінку домену через контекст і критерії питань.
Чи можна самостійно розміщувати Jev? Де підходить VPS
Inference означає запуск моделі для відповіді на запит. За даними перевірки від 5 жовтня, задокументована публічна пропозиція надає Jev inference через API TypeSafe. Переглянута документація не надає ні публічно завантажуваних ваг моделі, ні стандартного шляху локального розгортання. Відкритий код інтеграції — це не відкриті ваги моделі: ви можете самостійно розміщувати додаток, але Jev залишається зовнішнім.
VPS, або віртуальний приватний сервер, може розміщувати навколишній додаток. Відповідно розмірений AlexHost VPS може запускати backend або робітники, які викликають Jev. Він також може розміщувати чергу додатка, базу даних або інтерфейс перегляду. Доступ до моделі та плата за API є окремими. Вам не потрібна покупка сервера або GPU для спроби розміщеної служби; розмірюйте хостинг для трафіку додатків та локальних навантажень, а не для Jev inference.
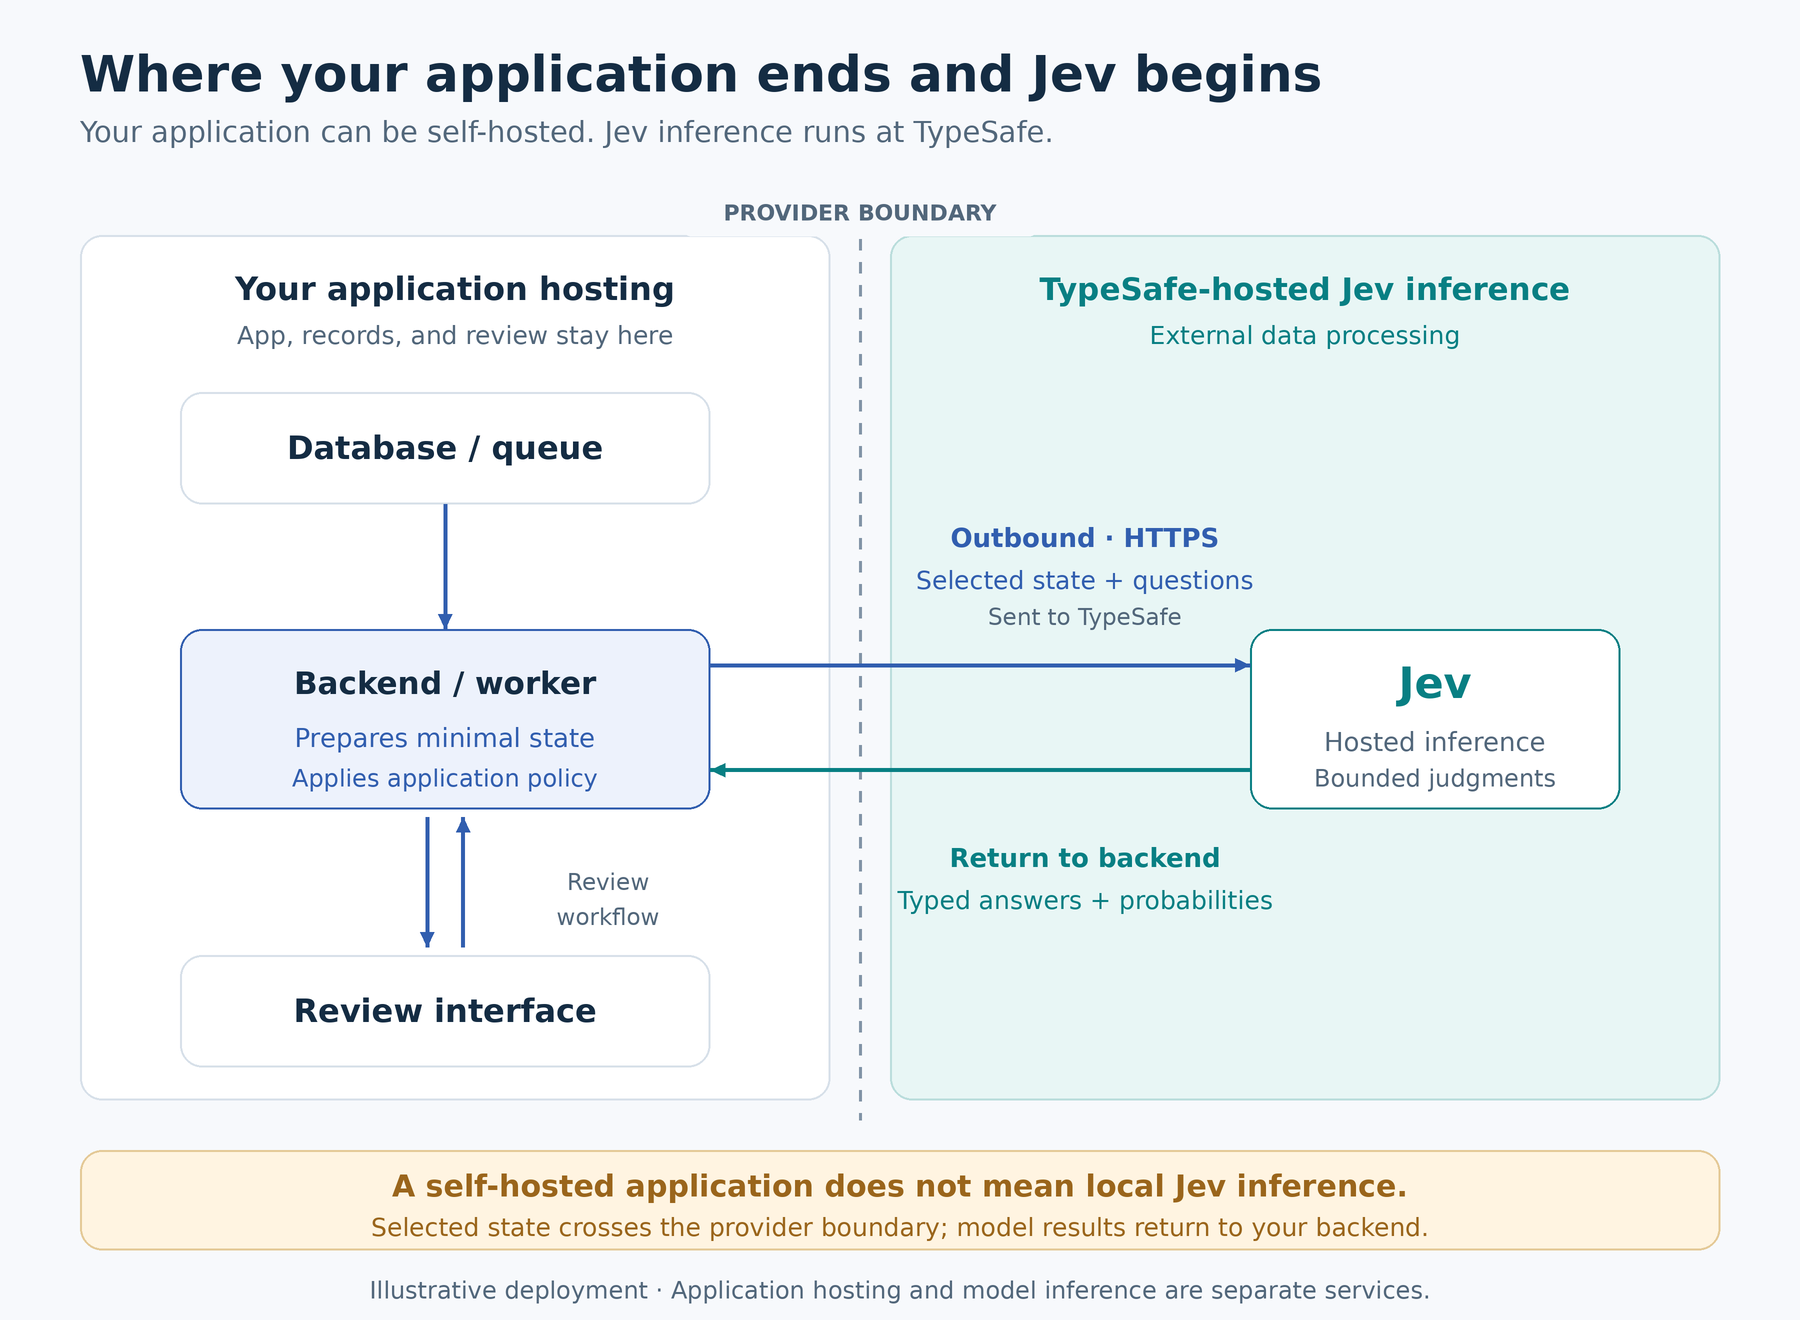
Додаток, записи та інтерфейс перегляду можуть працювати на вашому сервері, тоді як вибраний контекст передається TypeSafe для inference, а рішення повертаються до backend.
Попередження — самостійно розміщений додаток не означає локальний inference: Вибраний стан залишає межі вашого хостингу. Зобов’язання без навчання не передбачають за замовчуванням нульового збереження. Перевірте застосовні умови постачальника перед надсиланням конфіденційної інформації через цей робочий процес.
Політика конфіденційності TypeSafe виключає навчання або тонке налаштування на основі вхідних даних. Вона також описує хостинг у США та дозволяє збереження настільки, наскільки це розумно необхідно. Його правовий огляд пропонує підприємствам нульове збереження даних (ZDR) з урахуванням застосовних умов. Для робочих процесів персональних даних угода про обробку даних розглядає обробку та міжнародні передачі; місцезнаходження сервера — це лише частина рішення.
Надсилайте лише контекст, необхідний для рішення, виключаючи секрети та непотрібні персональні дані. Захистіть ключі постачальника та збережіть контроль доступу. Збережіть резервну копію з часовим обмеженням/обмеженням швидкості, наприклад чергу для перегляду; обробляйте невдалі запити окремо від невизначених відповідей. Як оператор додатка, ви залишаєтесь відповідальними за виправлення та моніторинг. Резервні копії та політика робочого процесу також залишаються з вами.
Кому варто розглянути Jev—і кому його пропустити?
Jev вносить семантичне судження в програмне забезпечення через запитання з попередньо визначеними відповідями.
- Він може маршрутизувати повідомлення клієнта
- Оцінити релевантність уривка
- Оцінити, чи відповідає запит встановленим критеріям, повертаючи типізовані результати та ймовірності, які код програми може використовувати.
Його привабливість полягає в тому, щоб зробити ці повторювані рішення швидкими та недорогими. Практична цінність все ще залежить від чітких критеріїв, відповідного контексту та продуктивності на ваших власних прикладах. Обмежені відповіді можуть бути неправильними, а ймовірності допомагають керувати перевіркою, а не гарантувати правильність.
Для клієнта, який просить «повернути додатковий платіж», роль Jev полягає в розпізнаванні запиту та допомозі його відправленню в потрібне місце. Записи, дозволи та виконання повернення коштів залишаються з програмою. Почніть з невеликого, придатного для перевірки робочого процесу, використовуючи розміщений API, а потім виміряйте точність, потреби в резервних варіантах та загальну вартість. Саме там обіцянка Jev стає конкретною: корисне судження, пов’язане з чітко визначеним наступним кроком.