Bilhete aberto
 +373 79 600002
 Chat ao vivo do Telegram
 F.A.Q
 Português
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Español
 Українська
 български
 Polski
 Indonesia
 中文 (中国)



 em todos os serviços de alojamento


O que é Jev? Modelo de Decisão do TypeSafe AI Explicado
Jev em Um Minuto: Decisões de IA, Não Outro Chatbot
Um cliente diz que a renovação da sua subscrição aparece duas vezes e pede reembolso. A sua aplicação de suporte precisa de um departamento e uma flag de pedido de reembolso, não de um ensaio. Jev by TypeSafe AI é um modelo de decisão que interpreta informações fornecidas e retorna respostas de um conjunto que você define. Funciona dentro de uma aplicação, não como um agente de suporte autónomo.
Pense numa secretária de triagem com caixas de departamento predefinidas e um cartão de classificação. Jev escolhe uma caixa, classifica a mensagem contra níveis descritos e retorna probabilidades juntamente com os seus julgamentos. Não compõe respostas nem escreve código. A secretária ainda pode colocar uma mensagem na caixa errada: restringir as respostas possíveis não torna todas as respostas corretas. A sua aplicação controla o próximo passo, incluindo revisão humana.
TypeSafe anunciou Jev em acesso público antecipado em 15 de setembro de 2026. O seu lançamento chamou atenção ao propor um lugar diferente para IA: decisões de software quotidiano em vez de outra janela de chat. Avaliar essa promessa significa separar cargas de trabalho úteis de números de manchete—e alojar a sua aplicação separadamente de alojar o próprio Jev.
Como Jev Difere de um LLM—e de Regras Ordinárias
O código pode verificar se uma transação foi liquidada ou se uma conta tem permissão. Interpretar “por favor, devolva o pagamento extra” requer julgamento semântico: compreender o significado em vez de verificar uma condição exata. Um grande modelo de linguagem (LLM) pode gerar texto, código e respostas estruturadas, incluindo classificações. Jev foca em questões como qual departamento deve receber uma mensagem. Sua saída tipada usa um tipo de resposta acordado e valores permitidos. Isso fixa a forma do rótulo, não se ele se adequa à mensagem.
Por exemplo: Um cliente escreve, “Você me cobrou duas vezes. Por favor, devolva o pagamento extra.” O código verifica se dois débitos foram liquidados. Jev poderia rotear a mensagem para billing dos departamentos permitidos: billing, technical ou account. Um LLM poderia redigir uma resposta.
| Abordagem | Função principal | Saída | Melhor adequação |
|---|---|---|---|
| Regras ordinárias | Avaliar condições exatas declaradas sem interpretar a intenção | Valores computados ou ramos de código predefinidos | Aritmética, permissões e lógica comercial conhecida |
| LLM generativo | Escrita e raciocínio flexível; também classificação | Texto gerado ou resultados estruturados restritos por esquema | Tarefas abertas, redação, geração de código e raciocínio estendido |
| Jev | Interpretar informações fornecidas usando descrições de respostas permitidas | Escolha, Pontuação ou probabilidade de sim | Julgamentos repetidos onde as respostas possíveis podem ser definidas antecipadamente |
LLMs modernos podem classificar e aderir a esquemas de saída suportados. Classificadores tradicionais específicos de tarefas já lidam com muitos trabalhos de rótulo fixo. A proposição de Jev é especialização e questões configuráveis em linguagem natural, não a invenção de classificação ou propriedade exclusiva de respostas estruturadas. Você descreve o julgamento em palavras em vez de treinar um classificador separado para cada nova questão.
TypeSafe chama isso de modelo “System One”, inspirado em julgamento rápido e intuitivo. Esta é sua terminologia, não uma categoria científica independente ou evidência de cognição humana. TypeSafe diz que seu método de treinamento, Reinforcement Learning for Calibrated Decisions (RLCD), visa fazer as probabilidades atribuídas refletirem resultados e incerteza. Esse objetivo não estabelece confiabilidade em todas as cargas de trabalho.
Como o Jev Funciona: Contexto Dentro, Três Tipos de Resposta Fora

Uma interface de programação de aplicações (API) permite que o código da aplicação envie pedidos e receba respostas. Com o Jev, a aplicação fornece estado—informações sobre a situação—e perguntas. O estado não é memória persistente: o Jev não navega, não obtém registos de faturação, nem se lembra automaticamente de pedidos anteriores.
Considere esta mensagem inventada: “A renovação da minha subscrição aparece duas vezes no meu extracto de cartão. Por favor, devolva o pagamento extra. Fico aborrecido por ter de fazer seguimento novamente, mas agradecia a sua ajuda.” O débito permanece uma reclamação do cliente. Critérios definem as categorias ou níveis descritivos utilizados para a avaliar. Os três primitivos do Jev, ou pequenos blocos de construção, cobrem estes tipos de pergunta:
| Tipo de pergunta | Pergunta e respostas permitidas | O que volta |
|---|---|---|
| Escolha | Qual departamento? Faturação: débitos/reembolsos/subscrições; técnico: funcionalidades avariadas; conta: início de sessão/perfil/acesso | Opção seleccionada, probabilidades para cada opção e confiança |
| Pontuação | Frustração expressa? 0: neutro, sem incómodo; 1: aborrecido mas construtivo; 2: linguagem hostil ou ameaça de cancelamento | Uma pontuação de 0–2 calculada a partir das probabilidades de nível, mais uma legenda de nível, probabilidades e confiança |
| Noul (nome da API para uma probabilidade sim/não) | Pede explicitamente dinheiro de volta ou crédito de conta? Uma reclamação de faturação sozinha não se qualifica | Probabilidade de sim de 0 a 1; sem campo de confiança nativa separado |
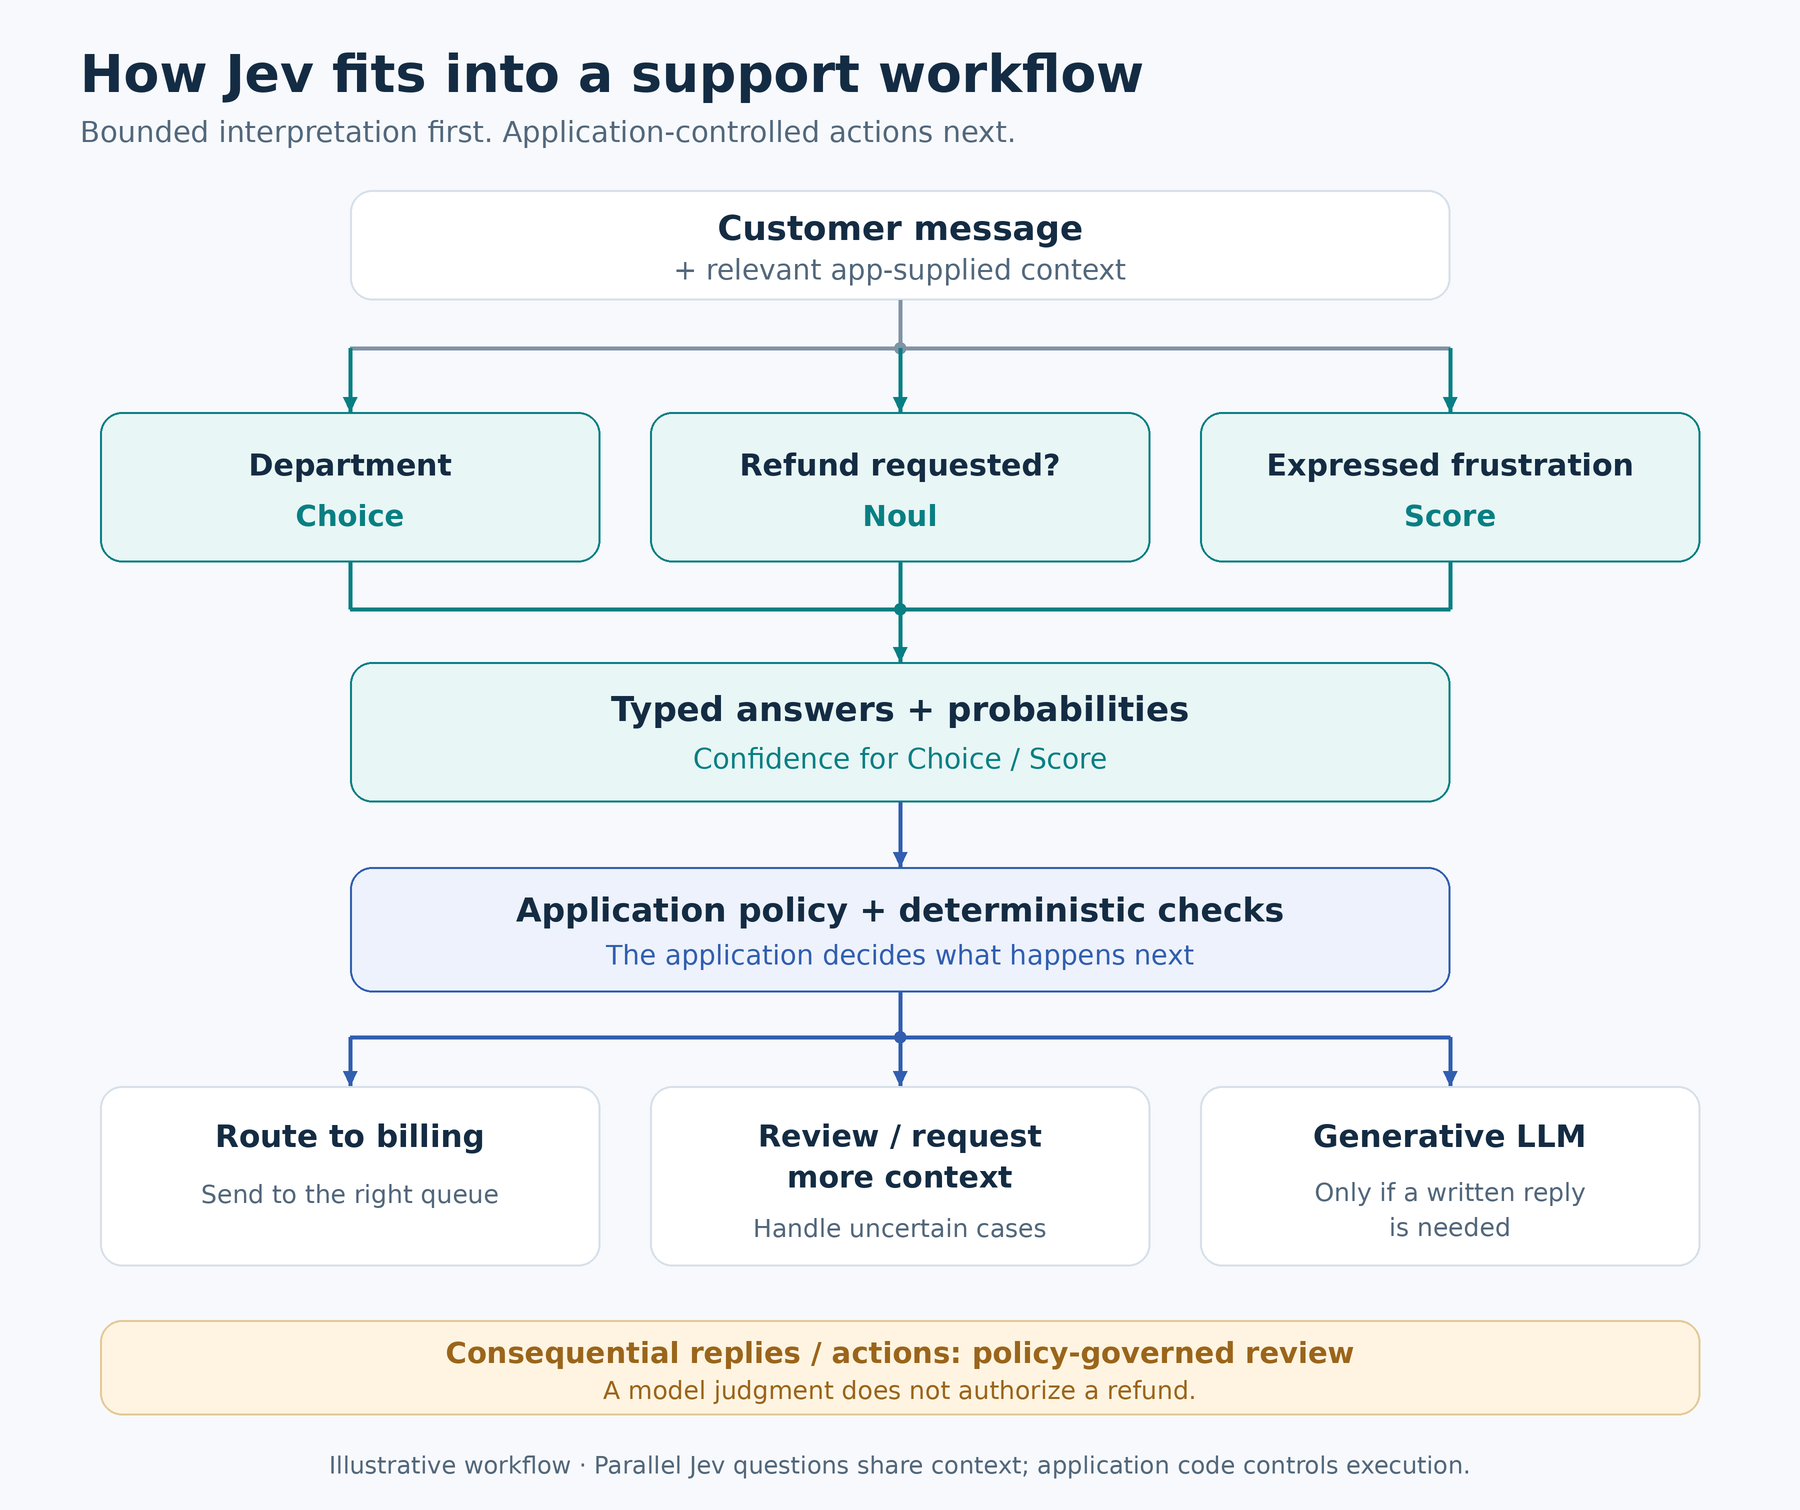
Os três recebem o mesmo contexto fornecido. A aplicação combina então os seus resultados e envia casos incertos para revisão; a redacção de respostas é tratada separadamente. As perguntas executam em paralelo contra estado partilhado; nenhuma lê a resposta de outra nessa chamada. Isto não torna as propriedades do cliente ou erros de previsão estatisticamente independentes. Uma Pontuação pode cair entre níveis porque faz a média dos seus números utilizando as suas probabilidades. Aqui descreve frustração expressa—não urgência, valor da transacção, ou elegibilidade de reembolso.
Se uma resposta determina quais registos recuperar ou opções oferecer a seguir, a pergunta dependente requer um pedido posterior. Perguntas adicionais aumentam a entrada faturável. Cada pedido também tem um limite de quanto texto pode aceitar, portanto não pode continuar a adicionar perguntas indefinidamente. Listas de departamentos reais também precisam de um caminho outro/nenhum ou revisão para mensagens fora destas três categorias.
O que você realmente pode fazer com Jev
No fluxo de suporte, um rótulo de faturamento pode enviar a mensagem para a fila correta, enquanto um sinalizador de solicitação de reembolso informa à equipe o que o cliente deseja. A classificação de frustração pode ajudar a priorizar o acompanhamento ou revisão humana junto com outros detalhes do ticket. Estes são usos ilustrativos, não resultados observados de Jev; urgência e impacto financeiro precisam de suas próprias evidências.
A investigação de faturamento segue um caminho diferente: a aplicação recupera registros de pagamento autoritários e verifica se há uma cobrança duplicada liquidada. A execução do reembolso deve satisfazer verificações exatas de política e verificar identidade e autorização, com aprovação apropriada. Uma previsão forte do modelo não altera esses requisitos. A redação de respostas pertence a um componente separado. Um cliente civil pode ter direito a um reembolso, e um cliente irritado pode estar enganado. O sentimento fica fora das verificações de direito. Outros fluxos de trabalho controlados por código dividem o trabalho de forma semelhante:
| Fluxo de trabalho | O que Jev decide | O que fica fora de Jev |
|---|---|---|
| Roteamento de modelo/ferramenta | Escolher entre opções nomeadas usando a solicitação fornecida e critérios de seleção | O código invoca o serviço selecionado, valida argumentos e trata fallback ou opções indisponíveis |
| Reordenação de passagens | Classificar a relevância de passagens já recuperadas para que os candidatos possam ser reordenados | A recuperação fornece candidatos; o código os ordena; outro componente escreve e verifica a resposta |
| Extração/marcação limitada | Escolher um rótulo de documento ou valor de campo candidato correspondente, incluindo “não declarado” | Um analisador ou outro modelo encontra valores candidatos; o código valida e monta o registro |
| Revisão de ação/alerta de texto | Sinalizar um significado arriscado declarado ou preocupação de política em descrições de ação ou alertas fornecidos | Permissões, isolamento, verificações exatas e revisão humana/segurança permanecem como controles separados |
Para empresas, a economia potencial vem da redução da classificação repetitiva, mas Jev não é um gerenciador de operações sem código pronto para uso. Um proprietário de integração deve definir categorias e rotular exemplos representativos. Esses exemplos ajudam a medir se erros e trabalho de revisão superam as economias. As regras confiáveis existentes permanecem úteis; a oportunidade está em mensagens que essas regras não conseguem interpretar bem.
Os auto-hospedadores poderiam adicionar interpretação a um helpdesk, fila ou fluxo de trabalho de documento existente sem possuir o modelo localmente. A triagem de segurança é revisão complementar: não substitui um firewall ou antivírus. Também não é um detector de ataque completo ou um limite para conceder autorização. A limitação de conteúdo adversarial documentada do TypeSafe significa que texto malicioso também pode influenciar este revisor. Uma preocupação sinalizada convida à investigação; uma entrada não sinalizada não é um certificado de segurança.
Por que o Lançamento Atraiu Atenção—e Como Ler os Números
Os números do Jev são uma razão para avaliá-lo, não uma previsão para sua aplicação. Em classificação de alto volume e roteamento interativo, pequenos custos e atrasos se acumulam. Julgamentos paralelos, preços de entrada baixos e sem cobrança de token de saída explicam seu apelo. A discussão de integração do LangChain e o relatório de implementação do Browserbase mostram interesse do desenvolvedor, não adoção universal ou maturidade de produção.
Em sua evidência de lançamento, relatórios TypeSafe mostram respostas de 70–500 ms de ponta a ponta e comparações de fluxo de trabalho aproximadamente 194× mais rápidas e 445× mais baratas. Descrevem os ganhos de destaque como tendendo ao extremo superior das melhorias esperadas no mundo real. Não são multiplicadores universais nem uma garantia de nível de serviço.
TypeSafe construiu seus próprios fluxos de trabalho de teste, usando probabilidades de outros modelos em vez de verdade fundamental factual independentemente rotulada.
- Testes da Costa Oeste, entradas de demonstração curtas que favoreciam Jev, e wrappers de comparação e configurações também limitam a amplitude de aplicação dos resultados.
- O relatório de 21 de setembro do Browserbase oferece um exemplo híbrido concreto: a latência mediana inicial do Stagehand Act caiu de 1,97 para 0,46 segundos—aproximadamente 4,3× mais rápido—com Jev selecionando candidatos limitados, Stagehand executando em código e um LLM tratando fallback. Este resultado relatado pelo implementador não é um benchmark independentemente reproduzido ou de propósito geral.
📝 Nota — preço de entrada não é custo total do sistema: Conforme verificado em 5 de outubro de 2026, TypeSafe lista jev-1.13.0 em $0,042 por milhão de tokens de entrada, sem cobrança de token de saída. Tokens são pedaços de texto—não solicitações ou contagens exatas de palavras—e entrada faturável inclui estado e perguntas.
Hipoteticamente, 100.000 solicitações × 1.000 tokens de entrada = 100 milhões de tokens, custando $4,20. Tentativas, outras chamadas de modelo, hospedagem, engenharia e revisão humana adicionam custos. Julgamentos repetitivos podem ser econômicos se a qualidade e as taxas de fallback forem aceitáveis; este exemplo não é nem uma cotação de sistema completo nem um retorno garantido.
O Que Probabilidades e Confiança Realmente Dizem
- Probabilidade expressa o quão provável o modelo considera uma resposta: faturação em vez de suporte técnico, ou sim para a pergunta de pedido de reembolso.
- Calibração descreve como essas estimativas correspondem aos resultados em previsões representativas.
Para uma previsão de chuva calibrada de 80%, a chuva deve ocorrer em aproximadamente 80% das ocasiões comparáveis atribuídas a essa probabilidade. Da mesma forma, aproximadamente 80% dos rótulos previstos nesse grupo de probabilidade devem estar corretos—não necessariamente qualquer rótulo específico. TypeSafe descreve treinamento orientado para calibração; sua carga de trabalho ainda precisa de validação.
Choice e Score também retornam confiança, uma estatística derivada de como a probabilidade é distribuída entre as respostas. Um Choice ilustrativo—não medido—de três opções com uma probabilidade máxima de 0,90 tem confiança de 0,85 sob a regra atualmente documentada. O primeiro estima o quão provável é a resposta; o segundo mostra o quão claramente ela supera as alternativas. Confiança não é uma verificação de fatos separada ou uma probabilidade de 85% de correção.
Um Score descreve a posição na sua escala: frustração baixa pode ser prevista com alta confiança. Um score intermediário pode refletir probabilidade concentrada no meio ou dividida entre extremos opostos, então inspecione a distribuição. Noul perto de 0,5 significa ambiguidade sim/não, não frustração média. Sua probabilidade de sim carrega a incerteza; não há campo de confiança nativo.
Aviso — valide antes de automatizar: Um limite copiado de outra carga de trabalho pode não se adequar às suas mensagens. Use exemplos representativos com rótulos conhecidos para verificar erros de previsão e com que frequência os casos precisam de revisão ou fallback.
Use esses resultados para decidir quais mensagens podem ser encaminhadas automaticamente, quais precisam de confirmação e quais exigem revisão humana. O limite deve refletir as consequências de um erro: encaminhar incorretamente um ticket reversível é diferente de autorizar um pagamento. Isso torna a confiança útil como um sinal de encaminhamento, com o limite escolhido para sua tarefa em vez de ser tratado como um número universal.
O Que Jev Não Pode Fazer—e O Que a Publicidade Omite
A afirmação “não pode alucinar” da TypeSafe descreve o formato de saída. Para confiabilidade prática, as questões relevantes são onde Jev tem dificuldades e como as falhas se manifestam. Uma previsão incorreta requer uma resposta diferente de uma solicitação de API falhada. Se a previsão estava correta, uma falha pode estar em como a lógica da aplicação a utilizou.
A interface restrita também exclui pedir a Jev prosa, código ou uma explicação do seu raciocínio. Para essas saídas, use um LLM generativo. No lado da entrada, Jev aceita texto, incluindo estruturas JSON suportadas—não imagens, áudio ou vídeo diretos. Trabalhar com mídia requer um serviço de pré-processamento separado para fornecer texto ou campos estruturados.
Aritmética exata, contagem e comparações de datas pertencem ao código. Julgamentos multi-hop estendidos também são um ajuste inadequado. Para extração, Jev seleciona candidatos ou componentes que você fornece; não gera livremente strings arbitrárias ou reconstrói um valor de reembolso a partir de um Score. As limitações do Jev 1.13 da TypeSafe, revisadas em 2 de outubro de 2026, agrupam várias outras fraquezas práticas:
- Redação e critérios: Leituras literais, indireção e critérios contraditórios podem enganar o modelo. Use perguntas estreitas e explícitas com descrições alinhadas.
- Contexto: Estado irrelevante pode distraí-lo. Recupere e filtre primeiro em vez de enviar cada registro disponível.
- Entradas e opções: Texto adversarial e ordenação de opções podem afetar respostas. Teste entradas maliciosas e opções reordenadas; esses testes não conferem imunidade.
A documentação atual do modelo diz que o inglês tem melhor desempenho; avalie outros idiomas no seu próprio conteúdo. Também lista limites de contexto exatos: a capacidade é limitada e uma janela grande não garante atenção perfeita. Aliases de versão podem mudar sem uma alteração de aplicação, portanto reavalie os limites ajustados quando as versões mudarem. Treinamento de modelo adicional específico do cliente não é oferecido atualmente; você molda o comportamento do domínio através do contexto e critérios de pergunta.
Pode Fazer Self-Host do Jev? Onde um VPS se Encaixa
Inference significa executar um modelo para responder a um pedido. Conforme verificado em 5 de outubro, a oferta pública documentada serve Jev inference através da API da TypeSafe. A documentação revisada não fornece nem pesos de modelo descarregáveis publicamente nem um caminho de implementação local padrão. O código de integração aberto não é pesos de modelo abertos: pode fazer self-host da aplicação, mas Jev permanece externo.
Um VPS, ou servidor privado virtual, pode hospedar a aplicação envolvente. Um VPS AlexHost dimensionado apropriadamente pode executar o backend ou workers que chamam Jev. Também pode hospedar a fila da aplicação, base de dados ou interface de revisão. O acesso ao modelo e as cobranças de API são separados. Não precisa de uma compra de servidor nem de uma GPU para experimentar o serviço hospedado; dimensione o hosting para o tráfego da aplicação e cargas de trabalho locais, não para Jev inference.
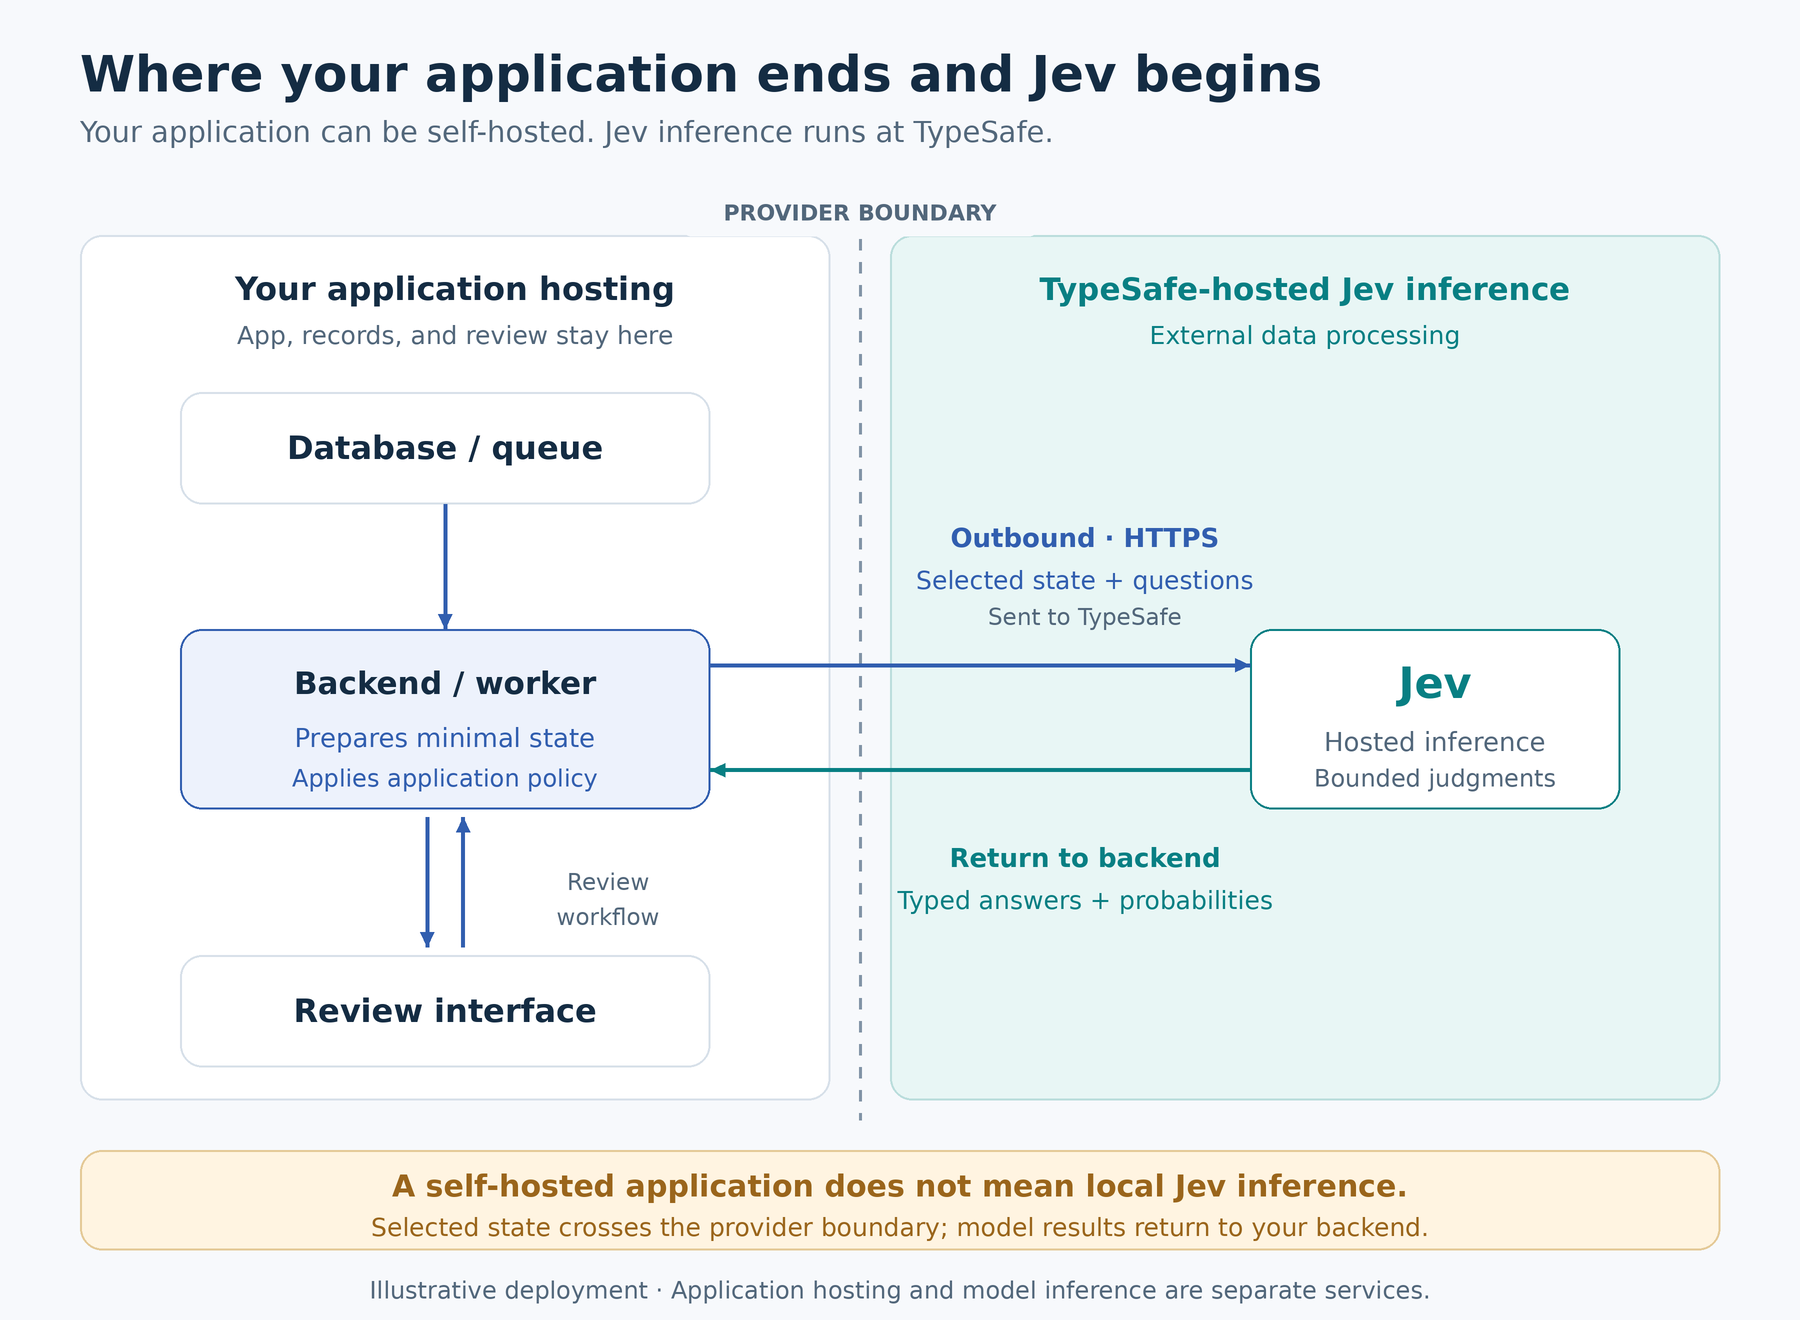
A aplicação, registos e interface de revisão podem ser executados no seu servidor, enquanto o contexto selecionado é transferido para TypeSafe para inference e as decisões regressam ao backend.
Aviso — uma aplicação self-hosted não significa inference local: O estado selecionado sai do seu limite de hosting. Os compromissos sem treinamento não implicam retenção zero padrão. Verifique os termos do fornecedor aplicável antes de enviar informações sensíveis através deste fluxo de trabalho.
A política de privacidade da TypeSafe exclui treinamento ou fine-tuning em inputs. Também descreve hosting nos EUA e permite retenção conforme razoavelmente necessário. A sua visão geral legal oferece zero data retention (ZDR) empresarial sujeito aos termos aplicáveis. Para fluxos de trabalho de dados pessoais, o acordo de processamento de dados aborda o processamento e transferências internacionais; a localização do servidor é apenas parte da decisão.
Envie apenas o contexto necessário para a decisão, deixando de fora segredos e dados pessoais desnecessários. Proteja as chaves do fornecedor e mantenha os controlos de acesso em vigor. Mantenha um fallback de timeout/rate-limit, como fila para revisão; trate pedidos falhados separadamente de respostas incertas. Como operador da aplicação, permanece responsável pela aplicação de patches e monitorização. Backups e política de fluxo de trabalho também ficam consigo.
Quem Deveria Considerar Jev—e Quem Deveria Pular?
Jev traz julgamento semântico para software através de perguntas com respostas predefinidas.
- Pode encaminhar uma mensagem de cliente
- Avaliar a relevância de uma passagem
- Estimar se um pedido atende aos critérios estabelecidos, retornando resultados tipados e probabilidades que o código da aplicação pode usar.
Seu apelo está em tornar essas decisões repetidas rápidas e baratas. O valor prático ainda depende de critérios claros, contexto relevante e desempenho em seus próprios exemplos. Respostas restritas podem estar erradas, e as probabilidades ajudam a guiar a revisão em vez de garantir correção.
Para o cliente pedindo para “devolver o pagamento extra,” o papel de Jev é reconhecer o pedido e ajudar a enviá-lo para o lugar certo. Registros, permissões e execução de reembolso permanecem com a aplicação. Comece com um fluxo de trabalho pequeno e revisável usando a API hospedada, depois meça precisão, necessidades de fallback e custo total. É aí que a promessa de Jev se torna concreta: julgamento útil conectado a um próximo passo bem definido.