Bilet otwarty
 +373 79 600002
 Czat na żywo w Telegramie
 F.A.Q
 Polski
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Español
 Português
 Українська
 български
 Indonesia
 中文 (中国)



 na wszystkich usługach hostingowych


Co to jest Jev? Wyjaśnienie modelu decyzyjnego TypeSafe AI
Jev w jedną minutę: Decyzje AI, nie kolejny chatbot
Klient mówi, że jego odnowienie subskrypcji pojawia się dwa razy i prosi o zwrot pieniędzy. Twoja aplikacja wsparcia potrzebuje działu i flagi żądania zwrotu, nie eseju. Jev by TypeSafe AI to model decyzyjny, który interpretuje dostarczone informacje i zwraca odpowiedzi z zestawu, który definiujesz. Działa wewnątrz aplikacji, a nie jako autonomiczny agent wsparcia.
Wyobraź sobie biurko sortownicze ze wstępnie zdefiniowanymi tacami działów i kartą oceny. Jev wybiera tacę, ocenia wiadomość względem opisanych poziomów i zwraca prawdopodobieństwa wraz ze swoimi ocenami. Nie pisze odpowiedzi ani nie koduje. Biurko może nadal włożyć wiadomość do złej tacy: ograniczenie możliwych odpowiedzi nie sprawia, że każda odpowiedź jest prawidłowa. Twoja aplikacja kontroluje następny krok, w tym przegląd przez człowieka.
TypeSafe ogłosił Jev w publicznym wczesnym dostępie 15 września 2026 r. Jego uruchomienie przyciągnęło uwagę, proponując inne miejsce dla AI: codzienne decyzje oprogramowania zamiast kolejnego okna czatu. Ocena tej obietnicy oznacza oddzielenie użytecznych obciążeń od liczb nagłówkowych—i hostowanie aplikacji od hostowania samego Jev.
Jak Jev różni się od LLM—i od zwykłych reguł
Kod może sprawdzić, czy transakcja została rozliczona lub czy konto ma uprawnienia. Interpretacja “proszę zwrócić dodatkową płatność” wymaga osądu semantycznego: zrozumienia znaczenia zamiast sprawdzania dokładnego warunku. Duży model językowy (LLM) może generować tekst, kod i ustrukturyzowane odpowiedzi, w tym klasyfikacje. Jev skupia się na pytaniach takich jak: który dział powinien otrzymać wiadomość. Jego wyjście typizowane wykorzystuje uzgodniony rodzaj odpowiedzi i dozwolone wartości. To ustala formę etykiety, a nie to, czy pasuje do wiadomości.
Na przykład: Klient pisze: “Naliczono mi opłatę dwa razy. Proszę zwrócić dodatkową płatność.” Kod sprawdza, czy dwie opłaty zostały rozliczone. Jev mógłby skierować wiadomość do biura rozliczeń z dozwolonych działów: biuro rozliczeń, wsparcie techniczne lub konto. LLM mógłby przygotować odpowiedź.
| Podejście | Główne zadanie | Wyjście | Najlepsze zastosowanie |
|---|---|---|---|
| Zwykłe reguły | Ocena dokładnie określonych warunków bez interpretacji intencji | Wartości obliczone lub predefiniowane gałęzie kodu | Arytmetyka, uprawnienia i znana logika biznesowa |
| Generatywny LLM | Pisanie i elastyczne rozumowanie; również klasyfikacja | Wygenerowany tekst lub wyniki ustrukturyzowane ograniczone schematem | Otwarte zadania, redagowanie, generowanie kodu i rozszerzone rozumowanie |
| Jev | Interpretacja dostarczonych informacji przy użyciu opisów dozwolonych odpowiedzi | Wybór, Wynik lub prawdopodobieństwo tak | Powtarzające się osądy, gdzie możliwe odpowiedzi można zdefiniować z góry |
Nowoczesne LLM mogą klasyfikować i przestrzegać obsługiwanych schematów wyjściowych. Tradycyjne klasyfikatory specjalistyczne już obsługują wiele zadań ze stałymi etykietami. Propozycja Jev to specjalizacja i pytania konfigurowalne w języku naturalnym, a nie wynalezienie klasyfikacji lub wyłączne posiadanie ustrukturyzowanych odpowiedzi. Opisujesz osąd słowami zamiast trenować oddzielny klasyfikator dla każdego nowego pytania.
TypeSafe nazywa to modelem “System One”, inspirowanym szybkim, intuicyjnym osądem. To jest ich terminologia, a nie niezależna kategoria naukowa ani dowód ludzkiego poznania. TypeSafe mówi, że jego metoda treningowa, Reinforcement Learning for Calibrated Decisions (RLCD), ma na celu sprawić, że przypisane prawdopodobieństwa odzwierciedlają wyniki i niepewność. Ten cel nie ustanawia niezawodności dla każdego obciążenia.
Jak działa Jev: Kontekst wejściowy, trzy rodzaje odpowiedzi

Interfejs programowania aplikacji (API) pozwala kodowi aplikacji wysyłać żądania i otrzymywać odpowiedzi. W przypadku Jev aplikacja dostarcza stan—informacje o sytuacji—oraz pytania. Stan nie jest trwałą pamięcią: Jev nie przegląda, nie pobiera zapisów rozliczeń ani automatycznie nie zapamiętuje wcześniejszych żądań.
Rozważ tę wymyśloną wiadomość: „Moje odnowienie subskrypcji pojawia się dwa razy na wyciągu z karty. Proszę zwrócić dodatkową płatność. Jestem zirytowany, że muszę ponownie się odzywać, ale doceniam Twoją pomoc.” Opłata pozostaje roszczeniem klienta. Kryteria definiują kategorie lub poziomy opisowe używane do oceny. Trzy prymitywy Jev, czyli małe bloki konstrukcyjne, obejmują te typy pytań:
| Typ pytania | Pytanie i dozwolone odpowiedzi | Co wraca |
|---|---|---|
| Wybór | Który dział? Rozliczenia: opłaty/zwroty/subskrypcje; techniczny: uszkodzone funkcje; konto: logowanie/profil/dostęp | Wybrana opcja, prawdopodobieństwa dla każdej opcji i pewność |
| Wynik | Wyrażona frustracja? 0: neutralna, brak irytacji; 1: zirytowany, ale konstruktywny; 2: wrogość w słowach lub groźba rezygnacji | Wynik od 0–2 obliczony na podstawie prawdopodobieństw poziomu, plus legenda poziomu, prawdopodobieństwa i pewność |
| Noul (nazwa API dla prawdopodobieństwa tak/nie) | Wyraźnie prosi o zwrot pieniędzy lub kredyt na konto? Sama skarga rozliczeniowa się nie kwalifikuje | Prawdopodobieństwo tak od 0 do 1; brak oddzielnego natywnego pola pewności |
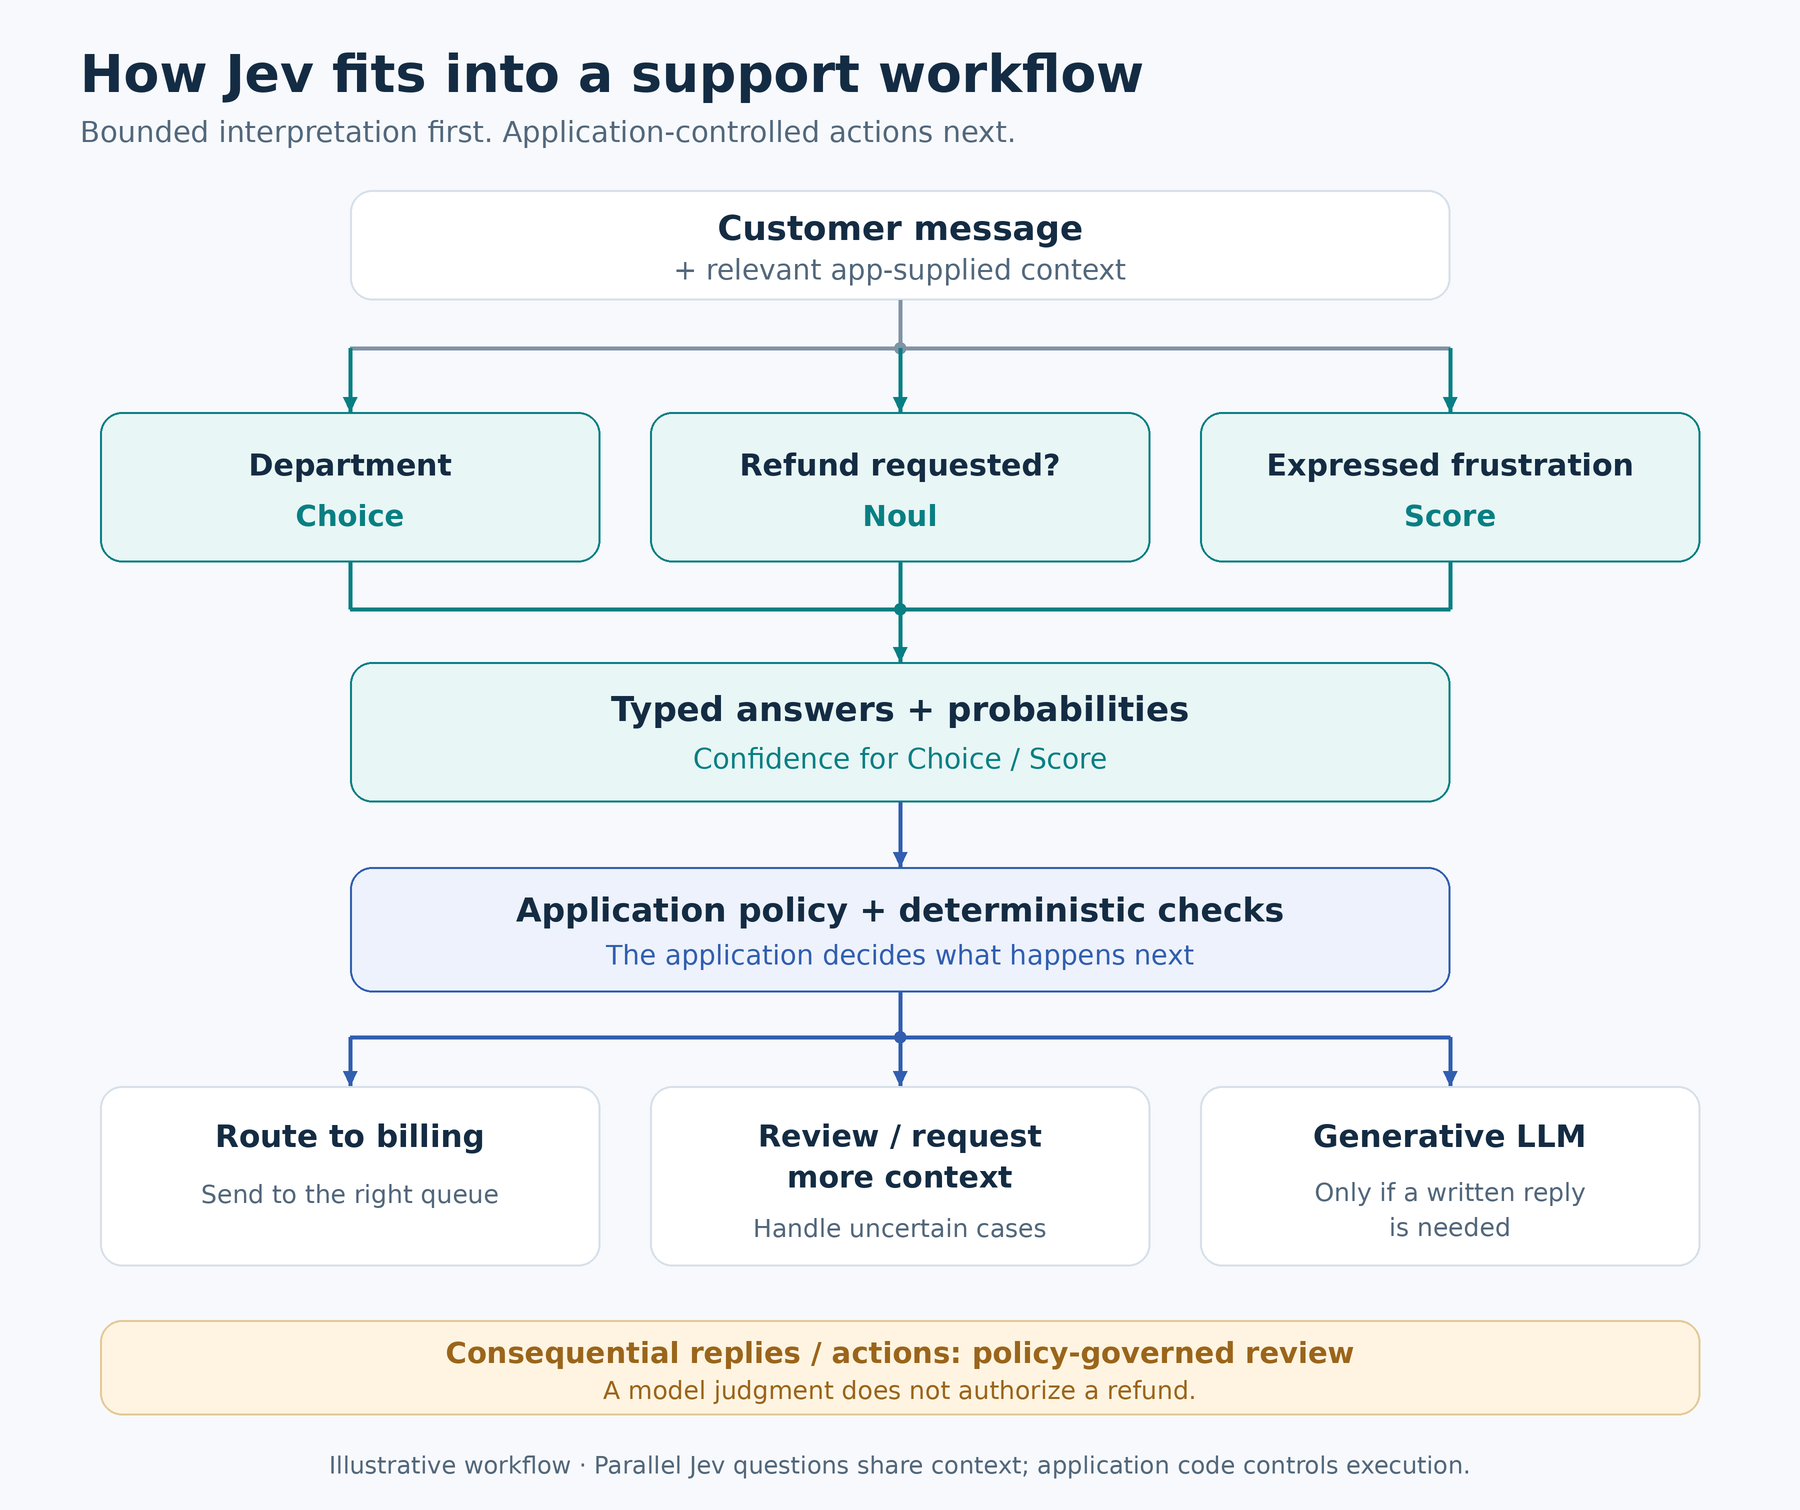
Wszystkie trzy otrzymują ten sam dostarczony kontekst. Aplikacja następnie łączy ich wyniki i wysyła niepewne przypadki do przeglądu; opracowanie odpowiedzi jest obsługiwane oddzielnie. Pytania działają równolegle względem wspólnego stanu; żadne nie czyta odpowiedzi drugiego w tym wywołaniu. To nie czyni właściwości klienta ani błędów predykcji statystycznie niezależnymi. Wynik może mieścić się między poziomami, ponieważ uśrednia ich liczby za pomocą ich prawdopodobieństw. Tutaj opisuje wyrażoną frustrację—nie pilność, wartość transakcji ani kwalifikowalność zwrotu.
Jeśli odpowiedź określa, które rekordy pobrać lub jakie opcje zaoferować dalej, pytanie zależne wymaga późniejszego żądania. Dodatkowe pytania zwiększają rozliczalny wkład. Każde żądanie ma również limit na ilość tekstu, który może zaakceptować, więc nie możesz w nieskończoność dodawać pytań. Rzeczywiste listy działów potrzebują również ścieżki inne/brak lub przeglądu dla wiadomości spoza tych trzech kategorii.
Co możesz faktycznie zrobić z Jev
W przepływie pracy wsparcia etykieta rozliczeniowa mogła wysłać wiadomość do właściwej kolejki, a flaga żądania zwrotu mówi pracownikom, czego chce klient. Ocena frustracji mogła pomóc w ustaleniu priorytetów dalszych działań lub przeglądu przez człowieka obok innych szczegółów zgłoszenia. To są ilustracyjne zastosowania, a nie obserwowane wyniki Jev; pilność i wpływ finansowy wymagają własnych dowodów.
Dochodzenie rozliczeniowe przebiega inną ścieżką: aplikacja pobiera autorytatywne rekordy płatności i sprawdza duplikat rozliczonej opłaty. Wykonanie zwrotu musi spełniać dokładne kontrole polityki i zweryfikować tożsamość i autoryzację, z odpowiednią aprobatą. Silna predykcja modelu nie zmienia tych wymagań. Redagowanie odpowiedzi należy do oddzielnego komponentu. Cywilny klient może mieć prawo do zwrotu, a zły klient może się mylić. Sentyment pozostaje poza kontrolami uprawnień. Inne przepływy pracy kontrolowane kodem dzielą pracę podobnie:
| Przepływ pracy | Co decyduje Jev | Co pozostaje poza Jev |
|---|---|---|
| Routing modelu/narzędzia | Wybierz spośród nazwanych opcji, używając dostarczonego żądania i kryteriów wyboru | Kod wywołuje wybraną usługę, waliduje argumenty i obsługuje fallback lub niedostępne opcje |
| Zmiana rankingu fragmentów | Oceń trafność już pobranych fragmentów, aby kandydaci mogli być przeorientowani | Pobieranie dostarcza kandydatów; kod je porządkuje; inny komponent pisze i weryfikuje odpowiedź |
| Ograniczona ekstrakcja/tagowanie | Wybierz etykietę dokumentu lub pasującą wartość pola kandydata, w tym „nie podano” | Parser lub inny model znajduje wartości kandydatów; kod waliduje i montuje rekord |
| Przegląd działania/alertu tekstowego | Oznacz flagą podane ryzykowne znaczenie lub problem polityki w dostarczonych opisach działań lub alertach | Uprawnienia, sandboxing, dokładne kontrole i przegląd człowieka/bezpieczeństwa pozostają oddzielnymi kontrolami |
Dla firm potencjalne oszczędności pochodzą z redukcji powtarzającego się sortowania, ale Jev nie jest gotowym do użytku menedżerem operacji bez kodu. Właściciel integracji musi zdefiniować kategorie i oznaczyć reprezentatywne przykłady. Te przykłady pomagają zmierzyć, czy błędy i praca przeglądu przeważają oszczędności. Istniejące niezawodne reguły pozostają przydatne; okazja tkwi w wiadomościach, których te reguły nie mogą dobrze interpretować.
Osoby samodzielnie hostujące mogą dodać interpretację do istniejącego helpdesku, kolejki lub przepływu pracy dokumentu bez posiadania modelu lokalnie. Przegląd bezpieczeństwa jest dodatkowym przeglądem: nie zastępuje zapory sieciowej ani oprogramowania antywirusowego. Nie jest to również kompletny detektor ataków ani granica dla udzielania autoryzacji. Udokumentowane ograniczenie zawartości adversarialnej TypeSafe oznacza, że złośliwy tekst może również wpłynąć na tego recenzenta. Oznaczona flagą obawa zaprasza do zbadania; nieoznaczony wejście nie jest certyfikatem bezpieczeństwa.
Dlaczego uruchomienie przyciągnęło uwagę—i jak czytać liczby
Liczby Jev to powód do oceny, a nie prognoza dla Twojej aplikacji. W sortowaniu dużych wolumenów i routingu interaktywnym małe koszty i opóźnienia się sumują. Równoległe oceny, niskie ceny wejścia i brak opłaty za tokeny wyjściowe wyjaśniają jego atrakcyjność. Dyskusja integracji LangChain i raport implementacji Browserbase pokazują zainteresowanie deweloperów, a nie uniwersalną adopcję lub dojrzałość produkcyjną.
W dowodach uruchomienia raporty TypeSafe pokazują odpowiedzi end-to-end 70–500 ms i porównania przepływów pracy około 194× szybsze i 445× tańsze. Opisują główne zyski jako na wysokim końcu oczekiwanych rzeczywistych ulepszeń. Nie są to uniwersalne mnożniki ani gwarancja poziomu usług.
TypeSafe zbudował własne testowe przepływy pracy, używając prawdopodobieństw innych modeli zamiast niezależnie oznaczonej faktycznej prawdy gruntowej.
- Testowanie na Wybrzeżu Zachodnim, krótkie wejścia demo, które faworyzowały Jev, oraz porównawcze wrappery i ustawienia również ograniczają, jak szeroko wyniki się stosują.
- Raport Browserbase z 21 września oferuje konkretny przykład hybrydowy: mediana opóźnienia wczesnego Stagehand Act spadła z 1,97 do 0,46 sekund—około 4,3× szybciej—z Jev wybierającym ograniczonych kandydatów, Stagehand wykonującym w kodzie i LLM obsługującym fallback. Ten wynik zgłoszony przez implementatora nie jest niezależnie odtworzonym ani uniwersalnym benchmarkiem.
📝 Uwaga — cena wejścia to nie całkowity koszt systemu: Jak sprawdzono 5 października 2026, TypeSafe wymienia jev-1.13.0 na $0,042 za milion tokenów wejściowych, bez opłaty za tokeny wyjściowe. Tokeny to fragmenty tekstu—nie żądania ani dokładne liczby słów—a billable input obejmuje stan i pytania.
Hipotetycznie, 100 000 żądań × 1 000 tokenów wejściowych = 100 milionów tokenów, kosztując $4,20. Ponowne próby, inne wywołania modelu, hosting, inżynieria i przegląd człowieka dodają koszty. Powtarzające się oceny mogą być ekonomiczne, jeśli jakość i wskaźniki fallback są akceptowalne; ten przykład nie jest ani kompletnym cytatem systemu, ani gwarantowanym zwrotem.
Co naprawdę mówią Ci prawdopodobieństwo i pewność
- Prawdopodobieństwo wyraża, jak bardzo model uważa odpowiedź za prawdopodobną: rozliczenia zamiast wsparcia technicznego, lub tak na pytanie o zwrot.
- Kalibracja opisuje, jak te szacunki odpowiadają wynikom w reprezentatywnych przewidywaniach.
Dla skalibrowanej prognozy deszczu na 80%, deszcz powinien padać w przybliżeniu na 80% porównywalnych okazji przypisanych temu prawdopodobieństwu. Podobnie, w przybliżeniu 80% przewidywanych etykiet w tej grupie prawdopodobieństwa powinno być poprawnych—niekoniecznie jakichkolwiek konkretnych etykiet. TypeSafe opisuje szkolenie zorientowane na kalibrację; Twoje obciążenie pracą nadal wymaga walidacji.
Choice i Score zwracają również pewność, statystykę pochodzącą z tego, jak prawdopodobieństwo jest rozłożone na odpowiedzi. Ilustracyjny—nie zmierzony—trzyopcyjny Choice z najwyższym prawdopodobieństwem 0.90 ma pewność 0.85 zgodnie z aktualną udokumentowaną regułą. Pierwszy szacuje, jak prawdopodobna jest odpowiedź; drugi pokazuje, jak wyraźnie pokonuje alternatywy. Pewność nie jest oddzielnym sprawdzeniem faktów ani 85% prawdopodobieństwem poprawności.
Score opisuje pozycję na Twojej skali: niskie frustracje można przewidzieć z wysoką pewnością. Wynik pośredni może odzwierciedlać prawdopodobieństwo skoncentrowane na środku lub podzielone między przeciwne skrajności, więc sprawdź rozkład. Noul bliski 0.5 oznacza dwuznaczność tak/nie, a nie średnią frustrację. Jej prawdopodobieństwo tak niesie niepewność; nie ma natywnego pola pewności.
Ostrzeżenie — waliduj przed automatyzacją: Próg skopiowany z innego obciążenia pracą może nie pasować do Twoich wiadomości. Użyj reprezentatywnych przykładów ze znanymi etykietami, aby sprawdzić zarówno błędy przewidywania, jak i jak często przypadki wymagają przeglądu lub fallbacku.
Użyj tych wyników, aby zdecydować, które wiadomości mogą być kierowane automatycznie, które wymagają potwierdzenia, a które wymagają przeglądu przez człowieka. Próg powinien odzwierciedlać konsekwencje błędu: błędne kierowanie odwracalnego zgłoszenia różni się od autoryzacji płatności. To sprawia, że pewność jest przydatna jako sygnał routingu, z progiem wybranym dla Twojego zadania zamiast traktowanym jako liczba uniwersalna.
Co Jev nie może robić—i co pomija szum medialny
Twierdzenie TypeSafe’a o braku „halucynacji” opisuje format wyjścia. Dla praktycznej niezawodności istotne pytania dotyczą tego, gdzie Jev ma problemy i jak się pojawiają błędy. Nieprawidłowa predykcja wymaga innej odpowiedzi niż nieudane żądanie API. Jeśli predykcja była prawidłowa, błąd może leżeć w tym, jak logika aplikacji ją wykorzystała.
Ograniczony interfejs wyklucza również możliwość proszenia Jev o prozę, kod lub wyjaśnienie jego rozumowania. Do tych wyjść użyj generatywnego LLM. Po stronie wejścia Jev akceptuje tekst, w tym obsługiwane struktury JSON—nie bezpośrednio obrazy, audio ani wideo. Praca z mediami wymaga oddzielnej usługi przetwarzania wstępnego, aby dostarczyć tekst lub pola strukturyzowane.
Dokładna arytmetyka, liczenie i porównania dat należą do kodu. Rozszerzone wieloetapowe osądy również są słabym rozwiązaniem. Do ekstrakcji Jev wybiera kandydatów lub komponenty, które dostarczasz; nie generuje swobodnie dowolnych ciągów ani nie rekonstruuje kwoty zwrotu ze Wyniku. Ograniczenia TypeSafe Jev 1.13, przejrzane 2 października 2026 r., grupują kilka innych praktycznych słabości:
- Sformułowanie i kryteria: Dosłowne odczytania, pośredniość i sprzeczne kryteria mogą wprowadzić model w błąd. Używaj wąskich, jawnych pytań z wyrównanymi opisami.
- Kontekst: Nieistotny stan może go rozpraszać. Najpierw pobierz i filtruj zamiast wysyłać każdy dostępny rekord.
- Wejścia i opcje: Tekst antagonistyczny i kolejność opcji mogą wpłynąć na odpowiedzi. Testuj złośliwe wejścia i zmienioną kolejność opcji; te testy nie dają odporności.
Bieżąca dokumentacja modelu mówi, że angielski działa najlepiej; oceń inne języki na własnej zawartości. Zawiera również dokładne limity kontekstu: pojemność jest ograniczona, a duże okno nie gwarantuje doskonałej uwagi. Aliasy wersji mogą się zmieniać bez zmiany aplikacji, więc ponownie oceń dostrojone progi, gdy wersje się zmienią. Dodatkowe szkolenie modelu specyficzne dla klienta nie jest obecnie oferowane; kształtujesz zachowanie domeny poprzez kontekst i kryteria pytań.
Czy możesz samodzielnie hostować Jev? Gdzie VPS się sprawdza
Inference oznacza uruchomienie modelu w celu odpowiedzi na żądanie. Jak sprawdzono 5 października, udokumentowana publiczna oferta obsługuje Jev inference przez API TypeSafe. Przejrzana dokumentacja nie zawiera ani publicznie dostępnych wag modelu, ani standardowej ścieżki wdrożenia lokalnego. Otwarty kod integracji to nie są otwarte wagi modelu: możesz samodzielnie hostować aplikację, ale Jev pozostaje zewnętrzny.
VPS, czyli wirtualny serwer prywatny, może hostować otaczającą aplikację. Odpowiednio skonfigurowany VPS AlexHost może uruchamiać backend lub workery, które wywołują Jev. Może również hostować kolejkę aplikacji, bazę danych lub interfejs przeglądu. Dostęp do modelu i opłaty za API są osobne. Nie potrzebujesz zakupu serwera ani GPU, aby spróbować usługę hostowaną; dostosuj hosting do ruchu aplikacji i lokalnych obciążeń, a nie do Jev inference.
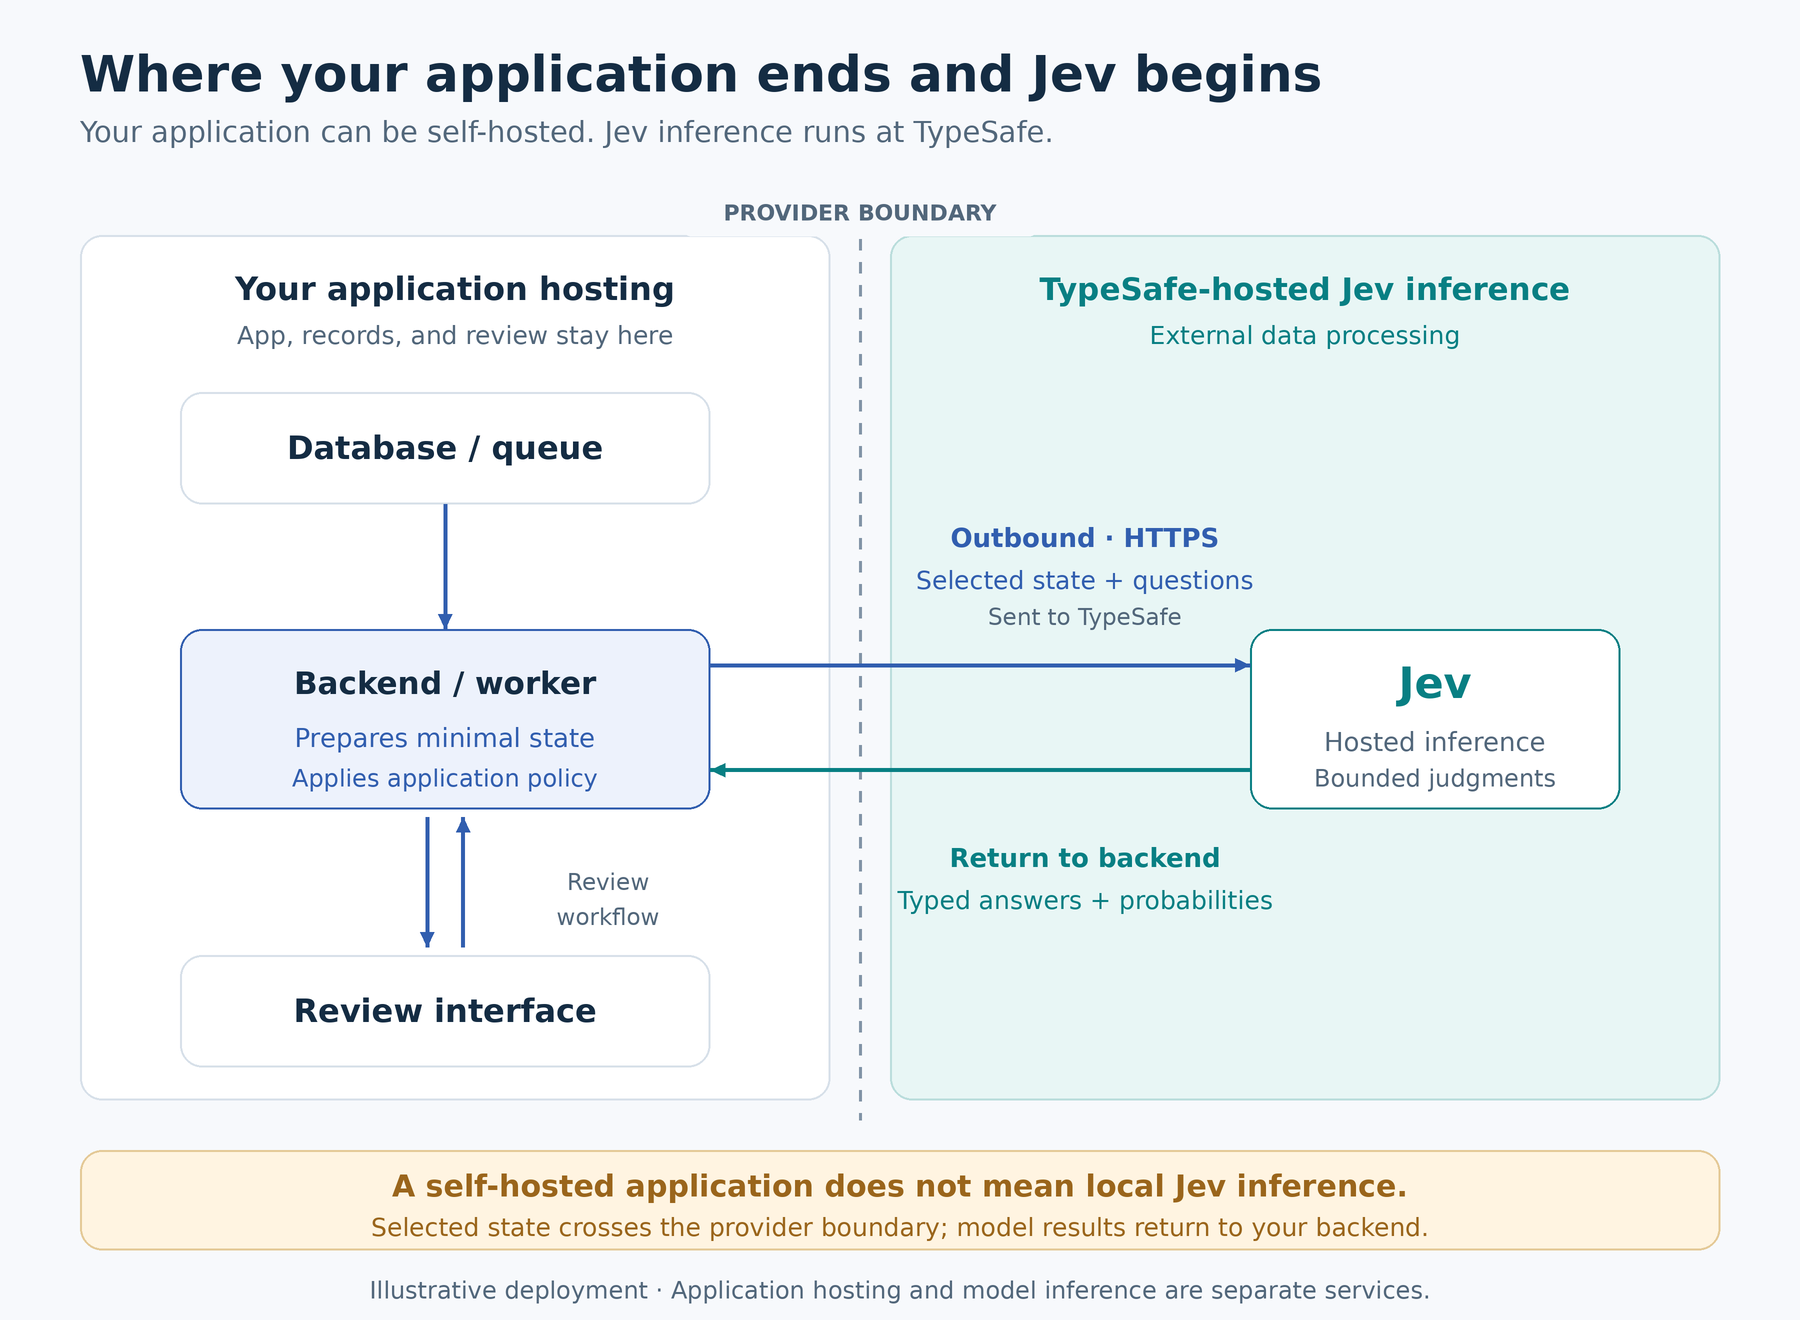
Aplikacja, rekordy i interfejs przeglądu mogą działać na Twoim serwerze, podczas gdy wybrany kontekst przechodzi do TypeSafe w celu inference, a decyzje wracają do backendu.
Ostrzeżenie — samodzielnie hostowana aplikacja nie oznacza lokalnego inference: Wybrane dane opuszczają granicę Twojego hostingu. Zobowiązania bez szkolenia nie oznaczają domyślnie zerowego przechowywania. Przed wysłaniem poufnych informacji przez ten przepływ pracy sprawdź odpowiednie warunki dostawcy.
Polityka prywatności TypeSafe wyklucza szkolenie lub dostrajanie na podstawie danych wejściowych. Opisuje również hosting w USA i pozwala na przechowywanie w zakresie uzasadnionym. Jego przegląd prawny oferuje zerowe przechowywanie danych (ZDR) dla przedsiębiorstw, z zastrzeżeniem odpowiednich warunków. W przypadku przepływów pracy zawierających dane osobowe, umowa przetwarzania danych dotyczy przetwarzania i transferów międzynarodowych; lokalizacja serwera to tylko część decyzji.
Wyślij tylko kontekst potrzebny do podjęcia decyzji, pomijając sekrety i niepotrzebne dane osobowe. Chroń klucze dostawcy i utrzymuj kontrolę dostępu. Utrzymuj rezerwę timeout/rate-limit, taką jak kolejka do przeglądu; obsługuj nieudane żądania oddzielnie od niepewnych odpowiedzi. Jako operator aplikacji pozostajesz odpowiedzialny za łatanie i monitorowanie. Kopie zapasowe i polityka przepływu pracy również pozostają w Twoim zakresie.
Kto powinien rozważyć Jev—a kto powinien go pominąć?
Jev wprowadza semantyczną ocenę do oprogramowania poprzez pytania ze wstępnie zdefiniowanymi odpowiedziami.
- Może kierować wiadomość klienta
- Ocenić trafność fragmentu tekstu
- Oszacować, czy żądanie spełnia określone kryteria, zwracając wpisane wyniki i prawdopodobieństwa, które kod aplikacji może wykorzystać.
Jego atrakcyjność polega na szybkim i tanim podejmowaniu tych powtarzających się decyzji. Praktyczna wartość nadal zależy od jasnych kryteriów, odpowiedniego kontekstu i wydajności na twoich własnych przykładach. Ograniczone odpowiedzi mogą być błędne, a prawdopodobieństwa pomagają kierować przeglądem, a nie gwarantują poprawność.
Dla klienta proszącego o “zwrot dodatkowej płatności”, rolą Jev jest rozpoznanie żądania i pomoc w wysłaniu go we właściwe miejsce. Rekordy, uprawnienia i wykonanie zwrotu pozostają w aplikacji. Zacznij od małego, przeglądanego przepływu pracy przy użyciu hostowanego API, a następnie zmierz dokładność, potrzeby fallbacku i całkowity koszt. To jest miejsce, gdzie obietnica Jev staje się konkretna: użyteczna ocena połączona z dobrze zdefiniowanym następnym krokiem.