Ticket öffnen
 +373 79 600002
 Telegramm Live Chat
 Häufige Fragen
 Deutsch
 English
 Русский
 Română
 Français
 Türkçe
 Español
 Português
 Українська
 български
 Polski
 Indonesia
 中文 (中国)



 bei allen Hosting-Diensten


Was ist Jev? TypeSafe AI’s Entscheidungsmodell erklärt
Jev in einer Minute: AI-Entscheidungen, kein weiterer Chatbot
Ein Kunde meldet, dass seine Abonnementverlängerung zweimal angezeigt wird, und fordert eine Rückerstattung. Ihre Support-Anwendung benötigt eine Abteilung und ein Rückerstattungsanfrage-Flag, keinen Essay. Jev von TypeSafe AI ist ein Entscheidungsmodell, das bereitgestellte Informationen interpretiert und Antworten aus einem von Ihnen definierten Satz zurückgibt. Es funktioniert innerhalb einer Anwendung, nicht als autonomer Support-Agent.
Stellen Sie sich einen Sortiertisch mit vordefinierten Abteilungsfächern und einer Bewertungskarte vor. Jev wählt ein Fach, bewertet die Nachricht anhand beschriebener Ebenen und gibt Wahrscheinlichkeiten zusammen mit seinen Urteilen zurück. Es verfasst keine Antworten und schreibt keinen Code. Der Tisch kann eine Nachricht trotzdem in das falsche Fach legen: Die Einschränkung möglicher Antworten macht nicht jede Antwort richtig. Ihre Anwendung kontrolliert den nächsten Schritt, einschließlich menschlicher Überprüfung.
TypeSafe kündigte Jev am 15. September 2026 in öffentlichem Early Access an. Der Start erregte Aufmerksamkeit, indem er einen anderen Platz für AI vorschlug: alltägliche Softwareentscheidungen statt eines weiteren Chat-Fensters. Die Bewertung dieses Versprechens bedeutet, nützliche Workloads von Schlagzeilenzahlen zu trennen – und Ihre Anwendung vom Hosting von Jev selbst zu unterscheiden.
Wie sich Jev von einem LLM unterscheidet – und von gewöhnlichen Regeln
Code kann überprüfen, ob eine Transaktion abgewickelt wurde oder ein Konto eine Berechtigung hat. Die Interpretation von „bitte erstatten Sie die Überzahlung” erfordert semantisches Urteilsvermögen: das Verständnis von Bedeutung statt der Überprüfung einer exakten Bedingung. Ein großes Sprachmodell (LLM) kann Text, Code und strukturierte Antworten generieren, einschließlich Klassifizierungen. Jev konzentriert sich auf Fragen wie welche Abteilung eine Nachricht erhalten sollte. Seine typisierte Ausgabe verwendet eine vereinbarte Antwortart und zulässige Werte. Das legt die Form des Labels fest, nicht ob es zur Nachricht passt.
Beispiel: Ein Kunde schreibt: „Sie haben mir zweimal berechnet. Bitte erstatten Sie die Überzahlung.” Code überprüft, ob zwei Gebühren abgewickelt wurden. Jev könnte die Nachricht von den zulässigen Abteilungen an billing weiterleiten: billing, technical oder account. Ein LLM könnte eine Antwort verfassen.
| Ansatz | Hauptaufgabe | Ausgabe | Beste Eignung |
|---|---|---|---|
| Gewöhnliche Regeln | Bewertung exakt angegebener Bedingungen ohne Interpretation der Absicht | Berechnete Werte oder vordefinierte Code-Verzweigungen | Arithmetik, Berechtigungen und bekannte Geschäftslogik |
| Generatives LLM | Schreiben und flexible Argumentation; auch Klassifizierung | Generierter Text oder schemagebundene strukturierte Ergebnisse | Offene Aufgaben, Entwürfe, Code-Generierung und erweiterte Argumentation |
| Jev | Bereitgestellte Informationen anhand von Beschreibungen zulässiger Antworten interpretieren | Auswahl, Bewertung oder eine Ja-Wahrscheinlichkeit | Wiederholte Urteile, bei denen mögliche Antworten im Voraus definiert werden können |
Moderne LLMs können klassifizieren und unterstützte Output-Schemas einhalten. Traditionelle aufgabenspezifische Klassifizierer bearbeiten bereits viele Jobs mit festen Labels. Jevs Proposition ist Spezialisierung und in natürlicher Sprache konfigurierbare Fragen, nicht die Erfindung von Klassifizierung oder exklusives Eigentum an strukturierten Antworten. Sie beschreiben das Urteil in Worten, anstatt für jede neue Frage einen separaten Klassifizierer zu trainieren.
TypeSafe nennt dies ein „System One”-Modell, inspiriert von schnellem, intuitivem Urteilsvermögen. Dies ist seine Terminologie, keine unabhängige wissenschaftliche Kategorie oder ein Beweis für menschliche Kognition. TypeSafe sagt, dass seine Trainingsmethode, Reinforcement Learning for Calibrated Decisions (RLCD), darauf abzielt, zugewiesene Wahrscheinlichkeiten an Ergebnisse und Unsicherheit anzupassen. Dieses Ziel begründet keine Zuverlässigkeit bei jeder Arbeitslast.
Wie Jev funktioniert: Kontext rein, drei Arten von Antworten raus

Eine Anwendungsprogrammierschnittstelle (API) ermöglicht es Anwendungscode, Anfragen zu senden und Antworten zu erhalten. Bei Jev stellt die App State bereit – Informationen über die Situation – und Fragen. State ist kein persistenter Speicher: Jev durchsucht nicht, ruft Abrechnungsunterlagen ab oder merkt sich automatisch frühere Anfragen.
Betrachten Sie diese erfundene Nachricht: „Meine Abonnementverlängerung erscheint zweimal auf meinem Kontoauszug. Bitte erstatten Sie die zusätzliche Zahlung. Ich bin verärgert, dass ich erneut nachfassen muss, aber ich würde Ihre Hilfe schätzen.” Die Gebühr bleibt ein Kundenanspruch. Kriterien definieren die Kategorien oder beschreibenden Ebenen, die zur Beurteilung verwendet werden. Jevs drei Primitive oder kleine Bausteine decken diese Fragetypen ab:
| Fragetyp | Frage und zulässige Antworten | Was kommt zurück |
|---|---|---|
| Choice | Welche Abteilung? Abrechnung: Gebühren/Rückerstattungen/Abonnements; Technik: fehlerhafte Funktionen; Konto: Anmeldung/Profil/Zugriff | Ausgewählte Option, Wahrscheinlichkeiten für jede Option und Konfidenz |
| Score | Ausgedrückte Frustration? 0: neutral, keine Verärgerung; 1: verärgert aber konstruktiv; 2: feindselige Formulierung oder Drohung zu kündigen | Ein 0–2-Score berechnet aus den Ebenenwahrscheinlichkeiten, plus eine Ebenenlegende, Wahrscheinlichkeiten und Konfidenz |
| Noul (Name der API für eine Ja/Nein-Wahrscheinlichkeit) | Fordert explizit Geld zurück oder Kontoguthaben? Eine Abrechnungsbeschwerde allein qualifiziert sich nicht | Ja-Wahrscheinlichkeit von 0 bis 1; kein separates natives Konfidenzfeld |
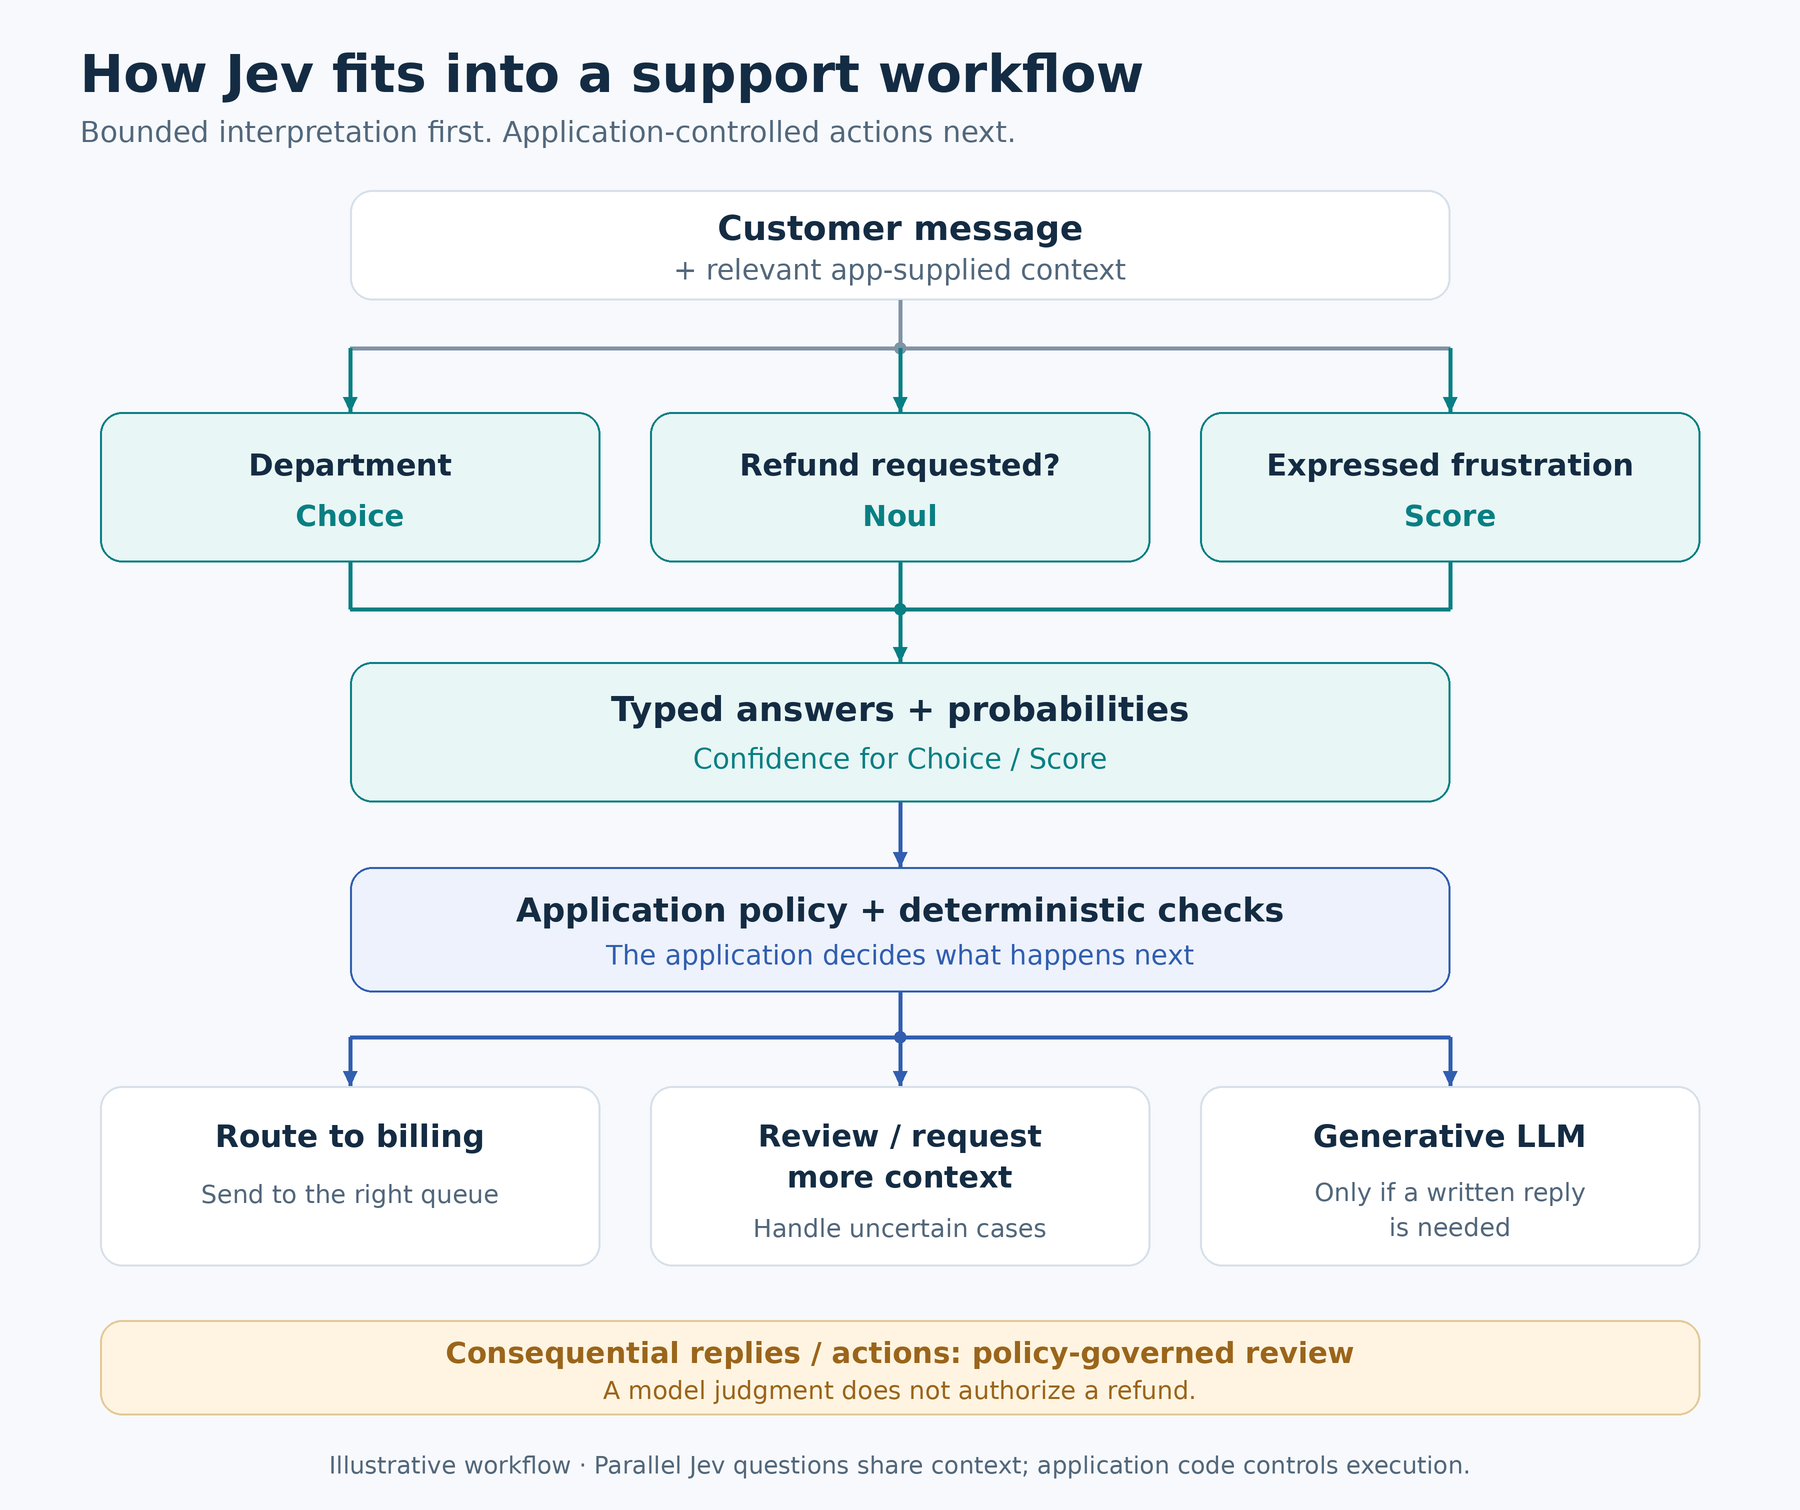
Alle drei erhalten denselben bereitgestellten Kontext. Die Anwendung kombiniert dann ihre Ergebnisse und sendet unsichere Fälle zur Überprüfung; die Antwortentwicklung wird separat bearbeitet. Fragen laufen parallel gegen gemeinsamen State; keine liest die Antwort einer anderen in diesem Aufruf. Dies macht Kundeneigenschaften oder Vorhersagefehler nicht statistisch unabhängig. Ein Score kann zwischen Ebenen liegen, da er ihre Zahlen unter Verwendung ihrer Wahrscheinlichkeiten mittelt. Hier beschreibt er ausgedrückte Frustration – nicht Dringlichkeit, Transaktionswert oder Rückerstattungsberechtigung.
Wenn eine Antwort bestimmt, welche Datensätze abgerufen oder welche Optionen als nächstes angeboten werden sollen, erfordert die abhängige Frage eine spätere Anfrage. Zusätzliche Fragen erhöhen die abrechenbare Eingabe. Jede Anfrage hat auch ein Limit für die Textmenge, die sie akzeptieren kann, daher können Sie nicht unbegrenzt Fragen hinzufügen. Echte Abteilungslisten benötigen auch einen Pfad „Sonstiges/Keine” oder „Überprüfung” für Nachrichten außerhalb dieser drei Kategorien.
Was Sie mit Jev tatsächlich tun können
Im Support-Workflow könnte ein Billing-Label die Nachricht in die richtige Warteschlange senden, während ein Refund-Request-Flag dem Personal zeigt, was der Kunde möchte. Die Frustrations-Bewertung könnte dabei helfen, Follow-up oder menschliche Überprüfung zusammen mit anderen Ticket-Details zu priorisieren. Dies sind illustrative Anwendungen, keine beobachteten Jev-Ergebnisse; Dringlichkeit und finanzielle Auswirkungen benötigen eigene Nachweise.
Die Billing-Untersuchung folgt einem anderen Weg: Die Anwendung ruft maßgebliche Zahlungsdatensätze ab und prüft auf doppelt abgerechnete Gebühren. Die Refund-Ausführung muss exakte Richtlinienprüfungen erfüllen und Identität sowie Autorisierung überprüfen, mit entsprechender Genehmigung. Eine starke Modellvorhersage ändert diese Anforderungen nicht. Reply-Entwürfe gehören zu einer separaten Komponente. Ein höflicher Kunde kann Anspruch auf eine Rückerstattung haben, und ein verägerter Kunde kann sich irren. Sentiment bleibt außerhalb von Anspruchsprüfungen. Andere codegesteuerte Workflows teilen die Arbeit ähnlich auf:
| Workflow | Was Jev entscheidet | Was außerhalb von Jev bleibt |
|---|---|---|
| Modell-/Tool-Routing | Wählen Sie unter benannten Optionen anhand der bereitgestellten Anfrage und Auswahlkriterien | Code ruft den ausgewählten Service auf, validiert Argumente und verwaltet Fallback oder nicht verfügbare Optionen |
| Passage-Reranking | Bewerten Sie die Relevanz bereits abgerufener Passages, damit Kandidaten neu geordnet werden können | Abruf liefert Kandidaten; Code ordnet sie; eine andere Komponente schreibt und überprüft die Antwort |
| Begrenzte Extraktion/Tagging | Wählen Sie ein Dokumentlabel oder einen passenden Kandidaten-Feldwert, einschließlich „nicht angegeben” | Ein Parser oder ein anderes Modell findet Kandidatenwerte; Code validiert und erstellt den Datensatz |
| Aktion/Text-Alert-Überprüfung | Kennzeichnen Sie eine angegebene riskante Bedeutung oder Richtlinienbedenklichkeit in bereitgestellten Aktionsbeschreibungen oder Alerts | Berechtigungen, Sandboxing, exakte Prüfungen und menschliche/Sicherheitsüberprüfung bleiben separate Kontrollen |
Für Unternehmen könnten potenzielle Einsparungen aus der Reduzierung wiederholter Sortierung entstehen, aber Jev ist kein vorkonfigurierter No-Code-Operationsmanager. Ein Integrationseigentümer muss Kategorien definieren und repräsentative Beispiele kennzeichnen. Diese Beispiele helfen zu messen, ob Fehler und Überprüfungsarbeit die Einsparungen überwiegen. Bestehende zuverlässige Regeln bleiben nützlich; die Gelegenheit liegt in Nachrichten, die diese Regeln nicht gut interpretieren können.
Self-Hoster könnten Interpretation zu einem bestehenden Helpdesk-, Warteschlangen- oder Dokument-Workflow hinzufügen, ohne das Modell lokal zu besitzen. Sicherheitsüberprüfung ist ergänzende Überprüfung: Sie ersetzt keine Firewall oder Antivirus. Sie ist auch kein vollständiger Angriffsdetektor oder eine Grenze für die Gewährung von Autorisierung. TypeSafe’s dokumentierte Einschränkung bei adversarialem Inhalt bedeutet, dass bösartiger Text auch diesen Reviewer beeinflussen kann. Ein gekennzeichnetes Anliegen lädt zur Untersuchung ein; eine ungekennzeichnete Eingabe ist kein Sicherheitszertifikat.
Warum der Start Aufmerksamkeit erregte – und wie man die Zahlen liest
Jevs Zahlen sind ein Grund, es zu bewerten, nicht eine Vorhersage für deine Anwendung. Bei großvolumigen Sortierungen und interaktivem Routing addieren sich kleine Kosten und Verzögerungen. Parallele Urteile, niedrige Input-Preisgestaltung und keine Output-Token-Gebühr erklären seinen Reiz. LangChains Integrationsdiskussion und Basebrowsers Implementierungsbericht zeigen Entwicklerinteresse, nicht universelle Adoption oder Produktionsreife.
In seinen Startbeweisen berichten TypeSafe-Reports von 70–500 ms End-to-End-Antworten und Workflow-Vergleichen, die ungefähr 194× schneller und 445× günstiger sind. Sie beschreiben die Schlagzeilengewinne als am oberen Ende der erwarteten realen Verbesserungen. Sie sind keine universellen Multiplikatoren oder eine Service-Level-Garantie.
TypeSafe erstellte seine eigenen Test-Workflows und nutzte die Wahrscheinlichkeiten anderer Modelle statt unabhängig gekennzeichneter faktischer Ground Truth.
- West-Coast-Tests, kurze Demo-Eingaben, die Jev bevorteilten, und Vergleichswrapper und Einstellungen begrenzen auch, wie breit die Ergebnisse anwendbar sind.
- Basebrowsers Bericht vom 21. September bietet ein konkretes Hybrid-Beispiel: Die frühe Stagehand Act-Median-Latenz fiel von 1,97 auf 0,46 Sekunden – etwa 4,3× schneller – mit Jev, das begrenzte Kandidaten auswählt, Stagehand im Code ausführt und ein LLM das Fallback handhabt. Dieses von Implementierern gemeldete Ergebnis ist kein unabhängig reproduzierter oder allgemeiner Benchmark.
📝 Hinweis – Input-Preisgestaltung ist nicht die Gesamtsystemkosten: Wie am 5. Oktober 2026 überprüft, listet TypeSafe jev-1.13.0 mit 0,042 $ pro Million Input-Token auf, ohne Output-Token-Gebühr. Tokens sind Textblöcke – nicht Anfragen oder genaue Wortanzahlen – und abrechenbare Eingaben umfassen Zustand und Fragen.
Hypothetisch gesehen: 100.000 Anfragen × 1.000 Input-Token = 100 Millionen Token, Kosten 4,20 $. Wiederholungen, andere Modellaufrufe, Hosting, Engineering und menschliche Überprüfung addieren Kosten hinzu. Wiederholte Urteile können wirtschaftlich sein, wenn Qualität und Fallback-Raten akzeptabel sind; dieses Beispiel ist weder ein vollständiges Systemangebot noch eine garantierte Rendite.
Was Wahrscheinlichkeiten und Konfidenz wirklich aussagen
- Wahrscheinlichkeit drückt aus, wie wahrscheinlich das Modell eine Antwort hält: Abrechnung statt technischer Support oder Ja zur Rückerstattungsanfrage.
- Kalibrierung beschreibt, wie gut diese Schätzungen mit den Ergebnissen über repräsentative Vorhersagen hinweg übereinstimmen.
Bei einer kalibrierten 80%-Regenvorhersage sollte es bei etwa 80% der vergleichbaren Fälle mit dieser Wahrscheinlichkeit regnen. Ebenso sollten etwa 80% der vorhergesagten Labels in dieser Wahrscheinlichkeitsgruppe korrekt sein – nicht unbedingt ein bestimmtes Label. TypeSafe beschreibt kalibrierungsorientiertes Training; Ihre Workload benötigt dennoch Validierung.
Choice und Score geben auch Konfidenz zurück, eine Statistik, die sich daraus ergibt, wie die Wahrscheinlichkeit auf die Antworten verteilt ist. Eine illustrative – nicht gemessene – dreioption Choice mit einer Top-Wahrscheinlichkeit von 0,90 hat unter der aktuellen dokumentierten Regel eine Konfidenz von 0,85. Die erste schätzt, wie wahrscheinlich die Antwort ist; die zweite zeigt, wie deutlich sie Alternativen schlägt. Konfidenz ist keine separate Faktenprüfung oder eine 85%-Wahrscheinlichkeit der Korrektheit.
Ein Score beschreibt die Position auf Ihrer Skala: niedriger Frust kann mit hoher Konfidenz vorhergesagt werden. Ein mittlerer Score kann Wahrscheinlichkeit konzentriert in der Mitte oder aufgeteilt zwischen entgegengesetzten Extremen widerspiegeln, daher überprüfen Sie die Verteilung. Noul nahe 0,5 bedeutet Ja/Nein-Mehrdeutigkeit, nicht mittlerer Frust. Seine Ja-Wahrscheinlichkeit trägt die Unsicherheit; es gibt kein natives Konfidenzfeld.
Warnung – validieren Sie vor der Automatisierung: Ein Schwellwert, der von einer anderen Workload kopiert wurde, passt möglicherweise nicht zu Ihren Nachrichten. Verwenden Sie repräsentative Beispiele mit bekannten Labels, um sowohl Vorhersagefehler als auch die Häufigkeit zu überprüfen, mit der Fälle überprüft oder auf Fallback angewiesen sind.
Verwenden Sie diese Ergebnisse, um zu entscheiden, welche Nachrichten automatisch weitergeleitet werden können, welche eine Bestätigung benötigen und welche eine menschliche Überprüfung erfordern. Der Schwellwert sollte die Folgen eines Fehlers widerspiegeln: Fehlleitung eines reversiblen Tickets unterscheidet sich von der Genehmigung einer Zahlung. Dies macht Konfidenz als Routing-Signal nützlich, wobei der Schwellwert für Ihre Aufgabe gewählt wird, anstatt als universelle Zahl behandelt zu werden.
Was Jev nicht kann – und was der Hype auslässt
TypeSafe’s Aussage „kann nicht halluzinieren” beschreibt das Ausgabeformat. Für praktische Zuverlässigkeit sind die relevanten Fragen, wo Jev Schwächen hat und wie Fehler auftreten. Eine falsche Vorhersage erfordert eine andere Reaktion als eine fehlgeschlagene API-Anfrage. War die Vorhersage korrekt, kann der Fehler in der Anwendungslogik liegen, die sie verwendet hat.
Die eingeschränkte Schnittstelle schließt auch aus, Jev um Prosa, Code oder eine Erklärung seiner Überlegungen zu bitten. Für diese Ausgaben verwenden Sie ein generatives LLM. Auf der Eingabenseite akzeptiert Jev Text, einschließlich unterstützter JSON-Strukturen – keine direkten Bilder, Audio oder Video. Die Arbeit mit Medien erfordert einen separaten Vorverarbeitungsdienst, um Text oder strukturierte Felder bereitzustellen.
Exakte Arithmetik, Zählung und Datumsvergleiche gehören in Code. Erweiterte mehrstufige Urteile sind ebenfalls ungeeignet. Bei der Extraktion wählt Jev Kandidaten oder Komponenten aus, die Sie bereitstellen; es generiert nicht frei beliebige Zeichenketten oder rekonstruiert einen Rückerstattungsbetrag aus einem Score. TypeSafe’s Jev 1.13 Einschränkungen, überprüft am 2. Oktober 2026, gruppieren mehrere weitere praktische Schwächen:
- Formulierung und Kriterien: Wörtliche Lesarten, Indirektheit und widersprüchliche Kriterien können das Modell irreführen. Verwenden Sie enge, explizite Fragen mit abgestimmten Beschreibungen.
- Kontext: Irrelevanter Zustand kann es ablenken. Rufen Sie zuerst ab und filtern Sie, anstatt jeden verfügbaren Datensatz zu senden.
- Eingaben und Optionen: Adversarischer Text und Optionsreihenfolge können Antworten beeinflussen. Testen Sie böswillige Eingaben und neu geordnete Optionen; diese Tests bieten keine Immunität.
Die aktuelle Modelldokumentation besagt, dass Englisch am besten funktioniert; evaluieren Sie andere Sprachen auf Ihrem eigenen Inhalt. Sie listet auch exakte Kontextgrenzen auf: Die Kapazität ist begrenzt, und ein großes Fenster garantiert keine perfekte Aufmerksamkeit. Versionsaliase können sich ohne Anwendungsänderung verschieben, daher bewerten Sie abgestimmte Schwellenwerte neu, wenn sich Versionen ändern. Kundenspezifisches zusätzliches Modelltraining wird derzeit nicht angeboten; Sie gestalten das Domänenverhalten durch Kontext und Fragekriterien.
Können Sie Jev selbst hosten? Wo ein VPS passt
Inference bedeutet, ein Modell auszuführen, um eine Anfrage zu beantworten. Wie am 5. Oktober überprüft, bietet das dokumentierte öffentliche Angebot Jev-Inference über die API von TypeSafe. Die überprüften Dokumente bieten weder öffentlich herunterladbare Modellgewichte noch einen Standard-Pfad für lokale Bereitstellung. Offener Integrationscode ist nicht offen Modellgewichte: Sie können die Anwendung selbst hosten, aber Jev bleibt extern.
Ein VPS, oder Virtual Private Server, kann die umgebende Anwendung hosten. Ein angemessen dimensionierter AlexHost VPS kann das Backend oder Worker ausführen, die Jev aufrufen. Er kann auch die Warteschlange, Datenbank oder Überprüfungsschnittstelle der Anwendung hosten. Modellzugriff und API-Gebühren sind separat. Sie benötigen weder einen Serverkauf noch eine GPU, um den gehosteten Service zu testen; dimensionieren Sie das Hosting für Anwendungsdatenverkehr und lokale Workloads, nicht für Jev-Inference.
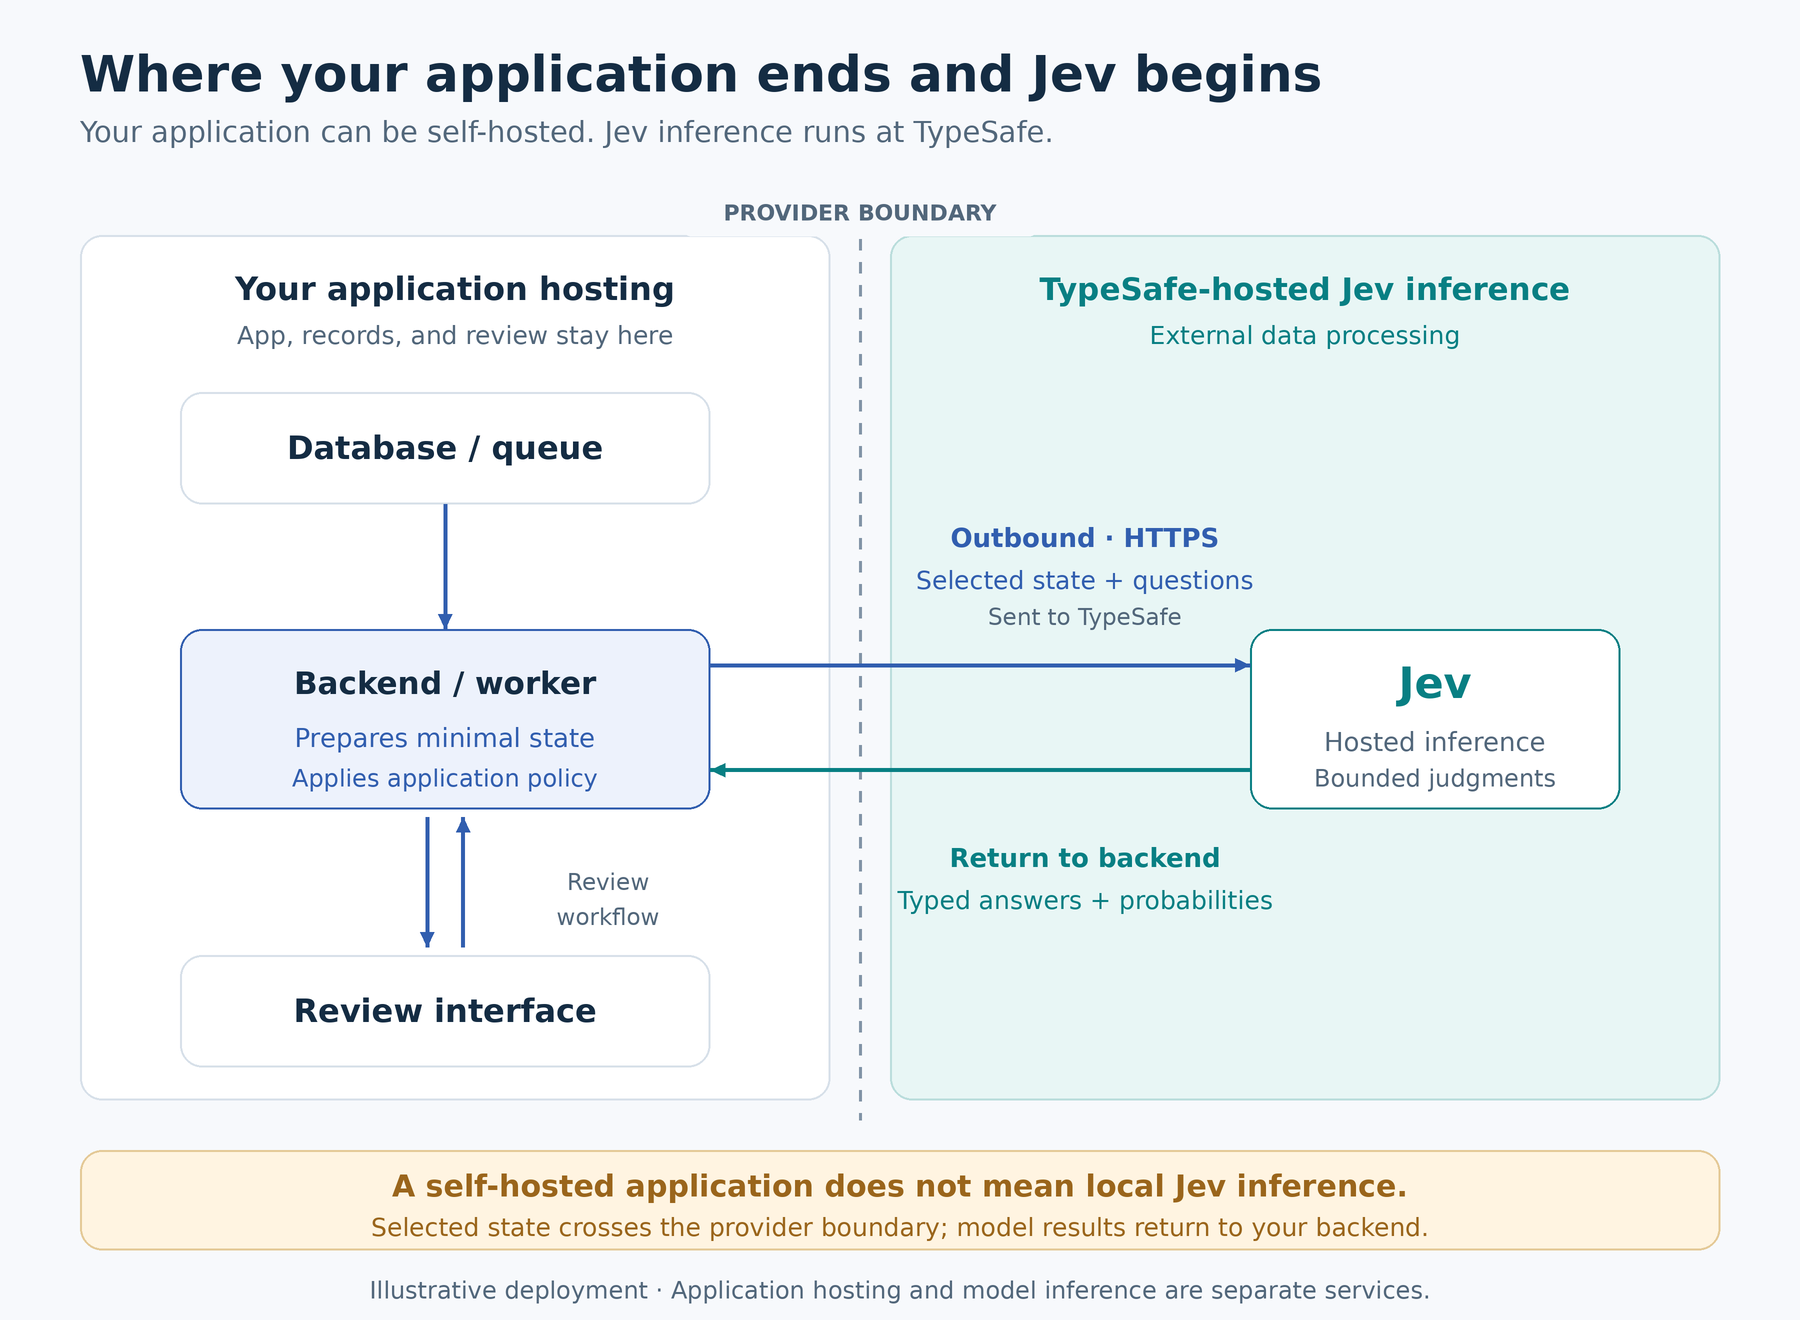
Die App, Datensätze und Überprüfungsschnittstelle können auf Ihrem Server ausgeführt werden, während ausgewählter Kontext zu TypeSafe für Inference übertragen wird und Entscheidungen zum Backend zurückkehren.
Warnung — eine selbst gehostete App bedeutet nicht lokale Inference: Ausgewählter Status verlässt Ihre Hosting-Grenze. Keine-Training-Verpflichtungen implizieren nicht standardmäßig Null-Aufbewahrung. Überprüfen Sie die geltenden Anbieterbestimmungen, bevor Sie sensible Informationen durch diesen Workflow senden.
Die Datenschutzrichtlinie von TypeSafe schließt Training oder Fine-Tuning bei Eingaben aus. Sie beschreibt auch US-Hosting und erlaubt Aufbewahrung, soweit angemessen erforderlich. Ihre rechtliche Übersicht bietet Enterprise Zero Data Retention (ZDR) gemäß geltenden Bedingungen. Für Workflows mit personenbezogenen Daten behandelt die Datenverarbeitungsvereinbarung Verarbeitung und internationale Übertragungen; der Serverstandort ist nur ein Teil der Entscheidung.
Senden Sie nur den Kontext, der für die Entscheidung erforderlich ist, und lassen Sie Geheimnisse und unnötige personenbezogene Daten weg. Schützen Sie Anbieter-Schlüssel und halten Sie Zugriffskontrolle aufrecht. Halten Sie einen Timeout/Rate-Limit-Fallback bereit, z. B. Warteschlange zur Überprüfung; behandeln Sie fehlgeschlagene Anfragen separat von unsicheren Antworten. Als Anwendungsbetreiber bleiben Sie für Patching und Überwachung verantwortlich. Sicherungen und Workflow-Richtlinie bleiben bei Ihnen.
Wer sollte Jev in Betracht ziehen – und wer sollte es überspringen?
Jev bringt semantische Urteile in Software durch Fragen mit vordefinierten Antworten.
- Es kann eine Kundennachricht weiterleiten
- Die Relevanz eines Textabschnitts bewerten
- Abschätzen, ob eine Anfrage festgelegte Kriterien erfüllt, und typisierte Ergebnisse sowie Wahrscheinlichkeiten zurückgeben, die der Anwendungscode verwenden kann.
Sein Reiz liegt darin, diese wiederholten Entscheidungen schnell und kostengünstig zu treffen. Der praktische Nutzen hängt immer noch von klaren Kriterien, relevantem Kontext und der Leistung bei Ihren eigenen Beispielen ab. Eingeschränkte Antworten können falsch sein, und Wahrscheinlichkeiten helfen bei der Überprüfung, garantieren aber keine Korrektheit.
Für den Kunden, der um „Rückgabe der zusätzlichen Zahlung” bittet, besteht Jevs Rolle darin, die Anfrage zu erkennen und sie an die richtige Stelle zu leiten. Datensätze, Berechtigungen und Rückerstattungsausführung bleiben bei der Anwendung. Beginnen Sie mit einem kleinen, überprüfbaren Workflow mit der gehosteten API, und messen Sie dann Genauigkeit, Fallback-Anforderungen und Gesamtkosten. Dort wird Jevs Versprechen konkret: nützliches Urteilsvermögen verbunden mit einem klar definierten nächsten Schritt.