Billet ouvert
 +373 79 600002
 Chat en direct Telegram
 F.A.Q
 Français
 English
 Русский
 Română
 Deutsch
 Türkçe
 Español
 Português
 Українська
 български
 Polski
 Indonesia
 中文 (中国)



 sur tous les services d'hébergement


Qu’est-ce que Jev ? Le modèle de décision TypeSafe AI expliqué
Jev en une minute : des décisions IA, pas un autre chatbot
Un client dit que le renouvellement de son abonnement apparaît deux fois et demande un remboursement. Votre application d’assistance a besoin d’un département et d’un indicateur de demande de remboursement, pas d’un essai. Jev de TypeSafe AI est un modèle de décision qui interprète les informations fournies et retourne des réponses d’un ensemble que vous définissez. Il fonctionne à l’intérieur d’une application, pas comme un agent d’assistance autonome.
Pensez à un bureau de tri avec des bacs de département prédéfinis et une carte d’évaluation. Jev choisit un bac, évalue le message par rapport aux niveaux décrits et retourne les probabilités aux côtés de ses jugements. Il ne compose pas de réponses et n’écrit pas de code. Le bureau peut toujours mettre un message dans le mauvais bac : restreindre les réponses possibles ne rend pas chaque réponse correcte. Votre application contrôle l’étape suivante, y compris l’examen humain.
TypeSafe a annoncé Jev en accès anticipé public le 15 septembre 2026. Son lancement a attiré l’attention en proposant une place différente pour l’IA : les décisions logicielles quotidiennes plutôt qu’une autre fenêtre de chat. Évaluer cette promesse signifie séparer les charges de travail utiles des chiffres accrocheurs—et héberger votre application plutôt que d’héberger Jev lui-même.
Comment Jev diffère d’un LLM—et des règles ordinaires
Le code peut vérifier si une transaction a été réglée ou si un compte dispose d’une permission. Interpréter « veuillez rembourser le paiement supplémentaire » nécessite un jugement sémantique : comprendre le sens plutôt que de vérifier une condition exacte. Un grand modèle de langage (LLM) peut générer du texte, du code et des réponses structurées, y compris des classifications. Jev se concentre sur des questions telles que quel département doit recevoir un message. Sa sortie typée utilise un type de réponse convenu et des valeurs autorisées. Cela fixe la forme de l’étiquette, non pas si elle correspond au message.
Par exemple : Un client écrit : « Vous m’avez facturisé deux fois. Veuillez rembourser le paiement supplémentaire. » Le code vérifie si deux frais ont été réglés. Jev pourrait acheminer le message vers billing parmi les départements autorisés : billing, technical ou account. Un LLM pourrait rédiger une réponse.
| Approche | Rôle principal | Sortie | Meilleur usage |
|---|---|---|---|
| Règles ordinaires | Évaluer les conditions exactes énoncées sans interpréter l’intention | Valeurs calculées ou branches de code prédéfinies | Arithmétique, permissions et logique métier connue |
| LLM génératif | Rédaction et raisonnement flexible ; également classification | Texte généré ou résultats structurés contraints par schéma | Tâches ouvertes, rédaction, génération de code et raisonnement étendu |
| Jev | Interpréter les informations fournies en utilisant des descriptions des réponses autorisées | Choix, Score ou probabilité de oui | Jugements répétés où les réponses possibles peuvent être définies à l’avance |
Les LLMs modernes peuvent classifier et respecter les schémas de sortie pris en charge. Les classificateurs traditionnels spécifiques aux tâches gèrent déjà de nombreux travaux à étiquettes fixes. La proposition de Jev est la spécialisation et les questions configurables en langage naturel, non pas l’invention de la classification ou la propriété exclusive des réponses structurées. Vous décrivez le jugement en mots plutôt que d’entraîner un classificateur distinct pour chaque nouvelle question.
TypeSafe appelle cela un modèle « System One », inspiré par le jugement rapide et intuitif. C’est sa terminologie, non pas une catégorie scientifique indépendante ou une preuve de cognition humaine. TypeSafe dit que sa méthode d’entraînement, Reinforcement Learning for Calibrated Decisions (RLCD), vise à faire en sorte que les probabilités assignées reflètent les résultats et l’incertitude. Cet objectif n’établit pas la fiabilité sur chaque charge de travail.
Comment fonctionne Jev : contexte en entrée, trois types de réponse en sortie

Une interface de programmation d’application (API) permet au code d’application d’envoyer des demandes et de recevoir des réponses. Avec Jev, l’application fournit l’état—des informations sur la situation—et des questions. L’état n’est pas une mémoire persistante : Jev ne navigue pas, ne récupère pas les dossiers de facturation et ne se souvient pas automatiquement des demandes antérieures.
Considérez ce message fictif : « Mon renouvellement d’abonnement apparaît deux fois sur mon relevé de carte. Veuillez retourner le paiement supplémentaire. Je suis agacé de devoir relancer, mais j’apprécierais votre aide. » La charge reste une réclamation client. Les critères définissent les catégories ou niveaux descriptifs utilisés pour l’évaluer. Les trois primitives de Jev, ou petits éléments constitutifs, couvrent ces types de questions :
| Type de question | Question et réponses autorisées | Ce qui revient |
|---|---|---|
| Choix | Quel département ? Facturation : charges/remboursements/abonnements ; technique : fonctionnalités cassées ; compte : connexion/profil/accès | Option sélectionnée, probabilités pour chaque option et confiance |
| Score | Frustration exprimée ? 0 : neutre, pas d’agacement ; 1 : agacé mais constructif ; 2 : langage hostile ou menace d’annulation | Un score de 0–2 calculé à partir des probabilités de niveau, plus une légende de niveau, les probabilités et la confiance |
| Noul (nom de l’API pour une probabilité oui/non) | Demande explicitement un remboursement ou un crédit de compte ? Une réclamation de facturation seule ne suffit pas | Probabilité oui de 0 à 1 ; pas de champ de confiance natif séparé |
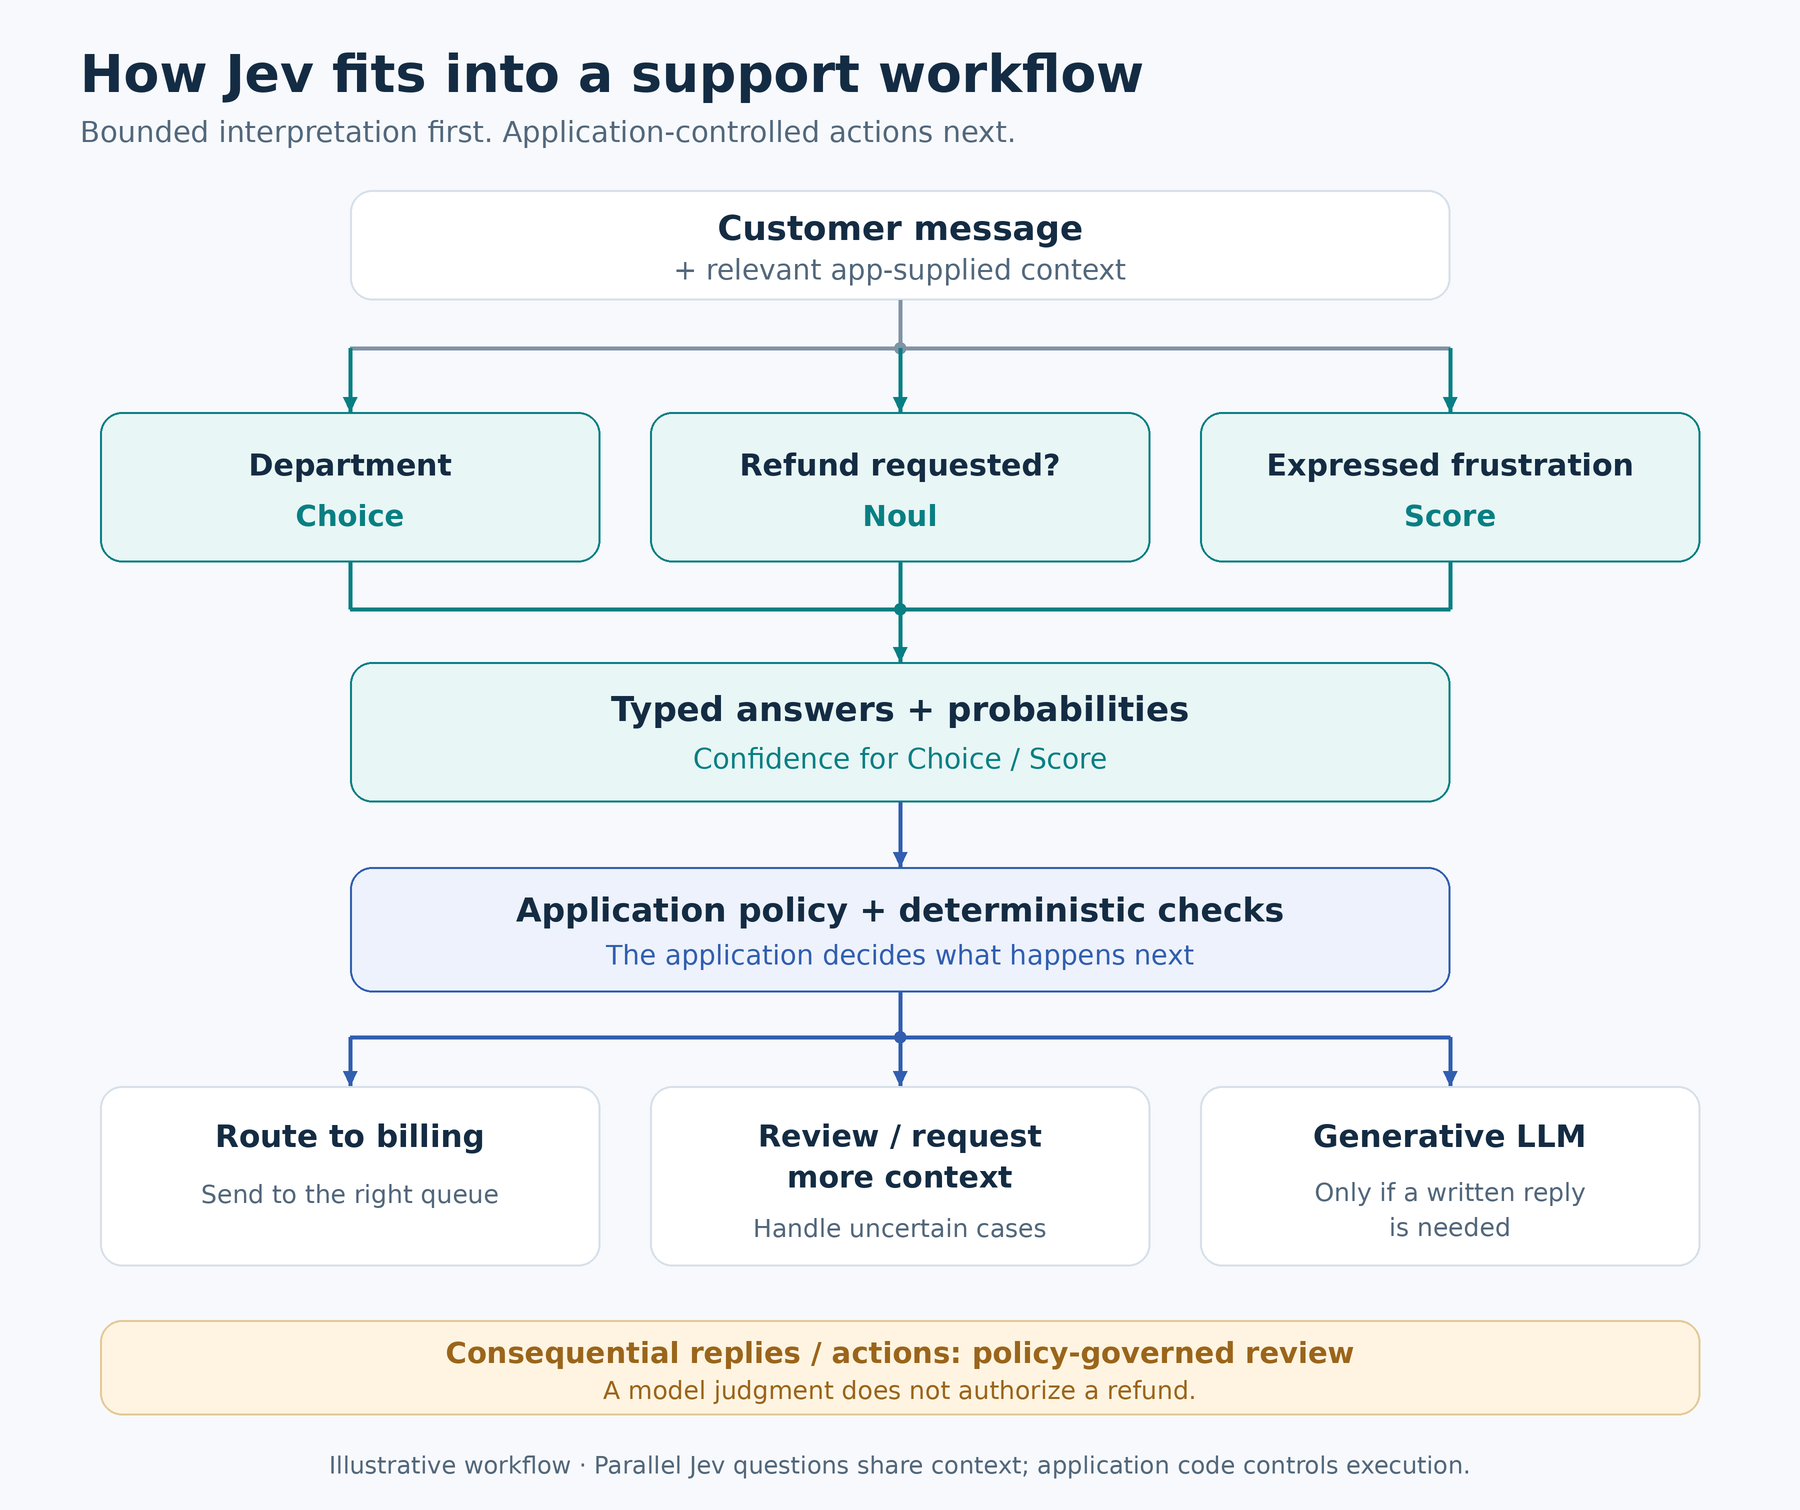
Les trois reçoivent le même contexte fourni. L’application combine ensuite leurs résultats et envoie les cas incertains pour examen ; la rédaction de réponses est traitée séparément. Les questions s’exécutent en parallèle sur un état partagé ; aucune ne lit la réponse d’une autre dans cet appel. Cela ne rend pas les propriétés client ou les erreurs de prédiction statistiquement indépendantes. Un Score peut se situer entre les niveaux car il fait la moyenne de leurs nombres en utilisant leurs probabilités. Ici, il décrit la frustration exprimée—non l’urgence, la valeur de la transaction ou l’admissibilité au remboursement.
Si une réponse détermine quels enregistrements récupérer ou quelles options offrir ensuite, la question dépendante nécessite une demande ultérieure. Des questions supplémentaires augmentent l’entrée facturable. Chaque demande a également une limite sur la quantité de texte qu’elle peut accepter, vous ne pouvez donc pas continuer à ajouter des questions indéfiniment. Les listes de départements réels ont également besoin d’un chemin autre/aucun ou d’examen pour les messages en dehors de ces trois catégories.
Ce que vous pouvez réellement faire avec Jev
Dans le flux de support, une étiquette de facturation pourrait envoyer le message vers la bonne file d’attente, tandis qu’un indicateur de demande de remboursement indique au personnel ce que le client souhaite. L’indice de frustration pourrait aider à prioriser le suivi ou l’examen humain aux côtés des autres détails du ticket. Ce sont des utilisations illustratives, non des résultats Jev observés ; l’urgence et l’impact financier nécessitent leurs propres preuves.
L’enquête de facturation suit un chemin différent : l’application récupère les enregistrements de paiement faisant autorité et vérifie les frais réglés en double. L’exécution du remboursement doit satisfaire aux vérifications exactes de la politique et vérifier l’identité et l’autorisation, avec l’approbation appropriée. Une forte prédiction du modèle ne change pas ces exigences. La rédaction de réponses appartient à un composant séparé. Un client civil peut avoir droit à un remboursement, et un client en colère peut se tromper. Le sentiment reste en dehors des vérifications de droit. D’autres flux de travail contrôlés par le code divisent le travail de manière similaire :
| Flux de travail | Ce que Jev décide | Ce qui reste en dehors de Jev |
|---|---|---|
| Routage modèle/outil | Choisir parmi les options nommées en utilisant la demande fournie et les critères de sélection | Le code invoque le service sélectionné, valide les arguments et gère les options de secours ou indisponibles |
| Réclassement de passage | Évaluer la pertinence des passages déjà récupérés pour que les candidats puissent être réordonnés | La récupération fournit les candidats ; le code les ordonne ; un autre composant rédige et vérifie la réponse |
| Extraction/étiquetage limité | Choisir une étiquette de document ou une valeur de champ candidat correspondante, y compris « non indiqué » | Un analyseur ou un autre modèle trouve les valeurs candidates ; le code valide et assemble l’enregistrement |
| Examen d’action/alerte texte | Signaler un sens risqué énoncé ou une préoccupation politique dans les descriptions d’action ou les alertes fournies | Les autorisations, l’isolation, les vérifications exactes et l’examen humain/sécurité restent des contrôles séparés |
Pour les entreprises, les économies potentielles proviennent de la réduction du tri répétitif, mais Jev n’est pas un gestionnaire d’opérations sans code prêt à l’emploi. Un propriétaire d’intégration doit définir les catégories et étiqueter les exemples représentatifs. Ces exemples aident à mesurer si les erreurs et le travail d’examen l’emportent sur les économies. Les règles fiables existantes restent utiles ; l’opportunité réside dans les messages que ces règles ne peuvent pas bien interpréter.
Les auto-hébergeurs pourraient ajouter une interprétation à un flux de travail de support, de file d’attente ou de document existant sans posséder le modèle localement. Le filtrage de sécurité est un examen supplémentaire : il ne remplace pas un pare-feu ou un antivirus. Ce n’est pas non plus un détecteur d’attaque complet ou une limite pour accorder l’autorisation. La limitation de contenu adversarial documentée de TypeSafe signifie que le texte malveillant peut également influencer cet examinateur. Une préoccupation signalée invite à une enquête ; une entrée non signalée n’est pas un certificat de sécurité.
Pourquoi le lancement a attiré l’attention—et comment lire les chiffres
Les chiffres de Jev sont une raison de l’évaluer, pas une prévision pour votre application. Dans le tri à haut volume et le routage interactif, les petits coûts et délais s’accumulent. Les jugements parallèles, la tarification d’entrée basse et l’absence de frais de jetons de sortie expliquent son attrait. La discussion d’intégration de LangChain et le rapport d’implémentation de Browserbase montrent l’intérêt des développeurs, pas l’adoption universelle ou la maturité de production.
Dans ses preuves de lancement, les rapports TypeSafe indiquent des réponses bout en bout de 70–500 ms et des comparaisons de flux de travail environ 194× plus rapides et 445× moins chères. Il décrit les gains phares comme étant vers l’extrémité supérieure des améliorations réelles attendues. Ce ne sont pas des multiplicateurs universels ni une garantie de niveau de service.
TypeSafe a construit ses propres flux de travail de test, en utilisant les probabilités d’autres modèles plutôt que la vérité de base factuelle indépendamment étiquetée.
- Les tests de la côte ouest, les entrées de démonstration courtes qui favorisaient Jev, et les wrappers de comparaison et les paramètres limitent également la portée de l’application des résultats.
- Le rapport du 21 septembre de Browserbase offre un exemple hybride concret : la latence médiane initiale de Stagehand Act est passée de 1,97 à 0,46 secondes—environ 4,3× plus rapide—avec Jev sélectionnant les candidats délimités, Stagehand exécutant en code, et un LLM gérant le secours. Ce résultat rapporté par l’implémenteur n’est pas un benchmark indépendamment reproduit ou à usage général.
📝 Note — la tarification d’entrée n’est pas le coût total du système : Comme vérifié le 5 octobre 2026, TypeSafe répertorie jev-1.13.0 à 0,042 $ par million de jetons d’entrée, sans frais de jetons de sortie. Les jetons sont des chunks de texte—pas des requêtes ou des comptages de mots exacts—et l’entrée facturable inclut l’état et les questions.
Hypothétiquement, 100 000 requêtes × 1 000 jetons d’entrée = 100 millions de jetons, coûtant 4,20 $. Les tentatives, les autres appels de modèle, l’hébergement, l’ingénierie et l’examen humain ajoutent des coûts. Les jugements répétitifs peuvent être économiques si la qualité et les taux de secours sont acceptables ; cet exemple n’est ni un devis de système complet ni un retour garanti.
Ce que les probabilités et la confiance vous disent réellement
- Probabilité exprime la probabilité que le modèle attribue à une réponse : facturation plutôt que support technique, ou oui à la question de demande de remboursement.
- Calibration décrit comment ces estimations correspondent aux résultats dans l’ensemble des prédictions représentatives.
Pour une prévision de pluie calibrée à 80 %, la pluie devrait se produire dans environ 80 % des occasions comparables auxquelles cette probabilité est attribuée. De même, environ 80 % des étiquettes prédites dans ce groupe de probabilité devraient être correctes—pas nécessairement une étiquette particulière. TypeSafe décrit l’entraînement orienté vers la calibration ; votre charge de travail nécessite toujours une validation.
Choice et Score retournent également la confiance, une statistique dérivée de la façon dont la probabilité est répartie entre les réponses. Un Choice illustratif—non mesuré—à trois options avec une probabilité maximale de 0,90 a une confiance de 0,85 selon la règle actuellement documentée. Le premier estime la probabilité que la réponse soit correcte ; le second montre à quel point elle surpasse les alternatives. La confiance n’est pas une vérification des faits séparée ou une probabilité de 85 % de correction.
Un Score décrit la position sur votre échelle : une faible frustration peut être prédite avec une confiance élevée. Un score intermédiaire peut refléter une probabilité concentrée au milieu ou répartie entre des extrêmes opposés, donc inspectez la distribution. Noul près de 0,5 signifie une ambiguïté oui/non, pas une frustration moyenne. Sa probabilité oui porte l’incertitude ; il n’y a pas de champ de confiance natif.
Avertissement — validez avant d’automatiser : Un seuil copié d’une autre charge de travail peut ne pas convenir à vos messages. Utilisez des exemples représentatifs avec des étiquettes connues pour vérifier à la fois les erreurs de prédiction et la fréquence à laquelle les cas nécessitent un examen ou un recours.
Utilisez ces résultats pour décider quels messages peuvent être acheminés automatiquement, lesquels nécessitent une confirmation et lesquels nécessitent un examen humain. Le seuil devrait refléter les conséquences d’une erreur : un mauvais acheminement d’un ticket réversible diffère de l’autorisation d’un paiement. Cela rend la confiance utile comme signal d’acheminement, le seuil étant choisi pour votre tâche plutôt que traité comme un nombre universel.
Ce que Jev ne peut pas faire—et ce que le battage médiatique omet
La affirmation “ne peut pas halluciner” de TypeSafe décrit le format de sortie. Pour la fiabilité pratique, les questions pertinentes sont les domaines où Jev a des difficultés et comment les défaillances se manifestent. Une prédiction incorrecte nécessite une réponse différente d’une demande API échouée. Si la prédiction était correcte, une défaillance peut résider dans la façon dont la logique applicative l’a utilisée.
L’interface contrainte exclut également de demander à Jev de la prose, du code ou une explication de son raisonnement. Pour ces sorties, utilisez un LLM génératif. Du côté des entrées, Jev accepte du texte, y compris les structures JSON supportées—pas d’images, d’audio ou de vidéo directs. Travailler avec des médias nécessite un service de prétraitement séparé pour fournir du texte ou des champs structurés.
L’arithmétique exacte, le comptage et les comparaisons de dates appartiennent au code. Les jugements multi-sauts étendus sont également un mauvais ajustement. Pour l’extraction, Jev sélectionne les candidats ou les composants que vous fournissez ; il ne génère pas librement des chaînes arbitraires ni ne reconstruit un montant de remboursement à partir d’un Score. Les limitations de Jev 1.13 de TypeSafe, examinées le 2 octobre 2026, regroupent plusieurs autres faiblesses pratiques :
- Formulation et critères : Les lectures littérales, l’indirection et les critères contradictoires peuvent induire le modèle en erreur. Utilisez des questions étroites et explicites avec des descriptions alignées.
- Contexte : L’état non pertinent peut le distraire. Récupérez et filtrez d’abord plutôt que d’envoyer chaque enregistrement disponible.
- Entrées et options : Le texte adversarial et l’ordre des options peuvent affecter les réponses. Testez les entrées malveillantes et les options réordonnées ; ces tests ne confèrent pas l’immunité.
La documentation actuelle du modèle indique que l’anglais fonctionne mieux ; évaluez les autres langues sur votre propre contenu. Elle liste également les limites exactes du contexte : la capacité est limitée, et une grande fenêtre ne garantit pas une attention parfaite. Les alias de version peuvent se déplacer sans modification d’application, donc réévaluez les seuils ajustés lors des changements de version. La formation supplémentaire du modèle spécifique au client n’est actuellement pas proposée ; vous façonnez le comportement du domaine par le contexte et les critères de question.
Pouvez-vous auto-héberger Jev ? Où un VPS s’intègre
Inference signifie exécuter un modèle pour répondre à une demande. Comme vérifié le 5 octobre, l’offre publique documentée fournit l’inférence Jev via l’API de TypeSafe. La documentation examinée ne fournit ni poids de modèle téléchargeables publiquement ni chemin de déploiement local standard. Le code d’intégration ouvert n’est pas des poids de modèle ouverts : vous pouvez auto-héberger l’application, mais Jev reste externe.
Un VPS, ou serveur privé virtuel, peut héberger l’application environnante. Un VPS AlexHost de taille appropriée peut exécuter le backend ou les workers qui appellent Jev. Il peut également héberger la file d’attente, la base de données ou l’interface d’examen de l’application. L’accès au modèle et les frais d’API sont séparés. Vous n’avez besoin ni d’un achat de serveur ni d’un GPU pour essayer le service hébergé ; dimensionnez l’hébergement pour le trafic d’application et les charges de travail locales, pas pour l’inférence Jev.
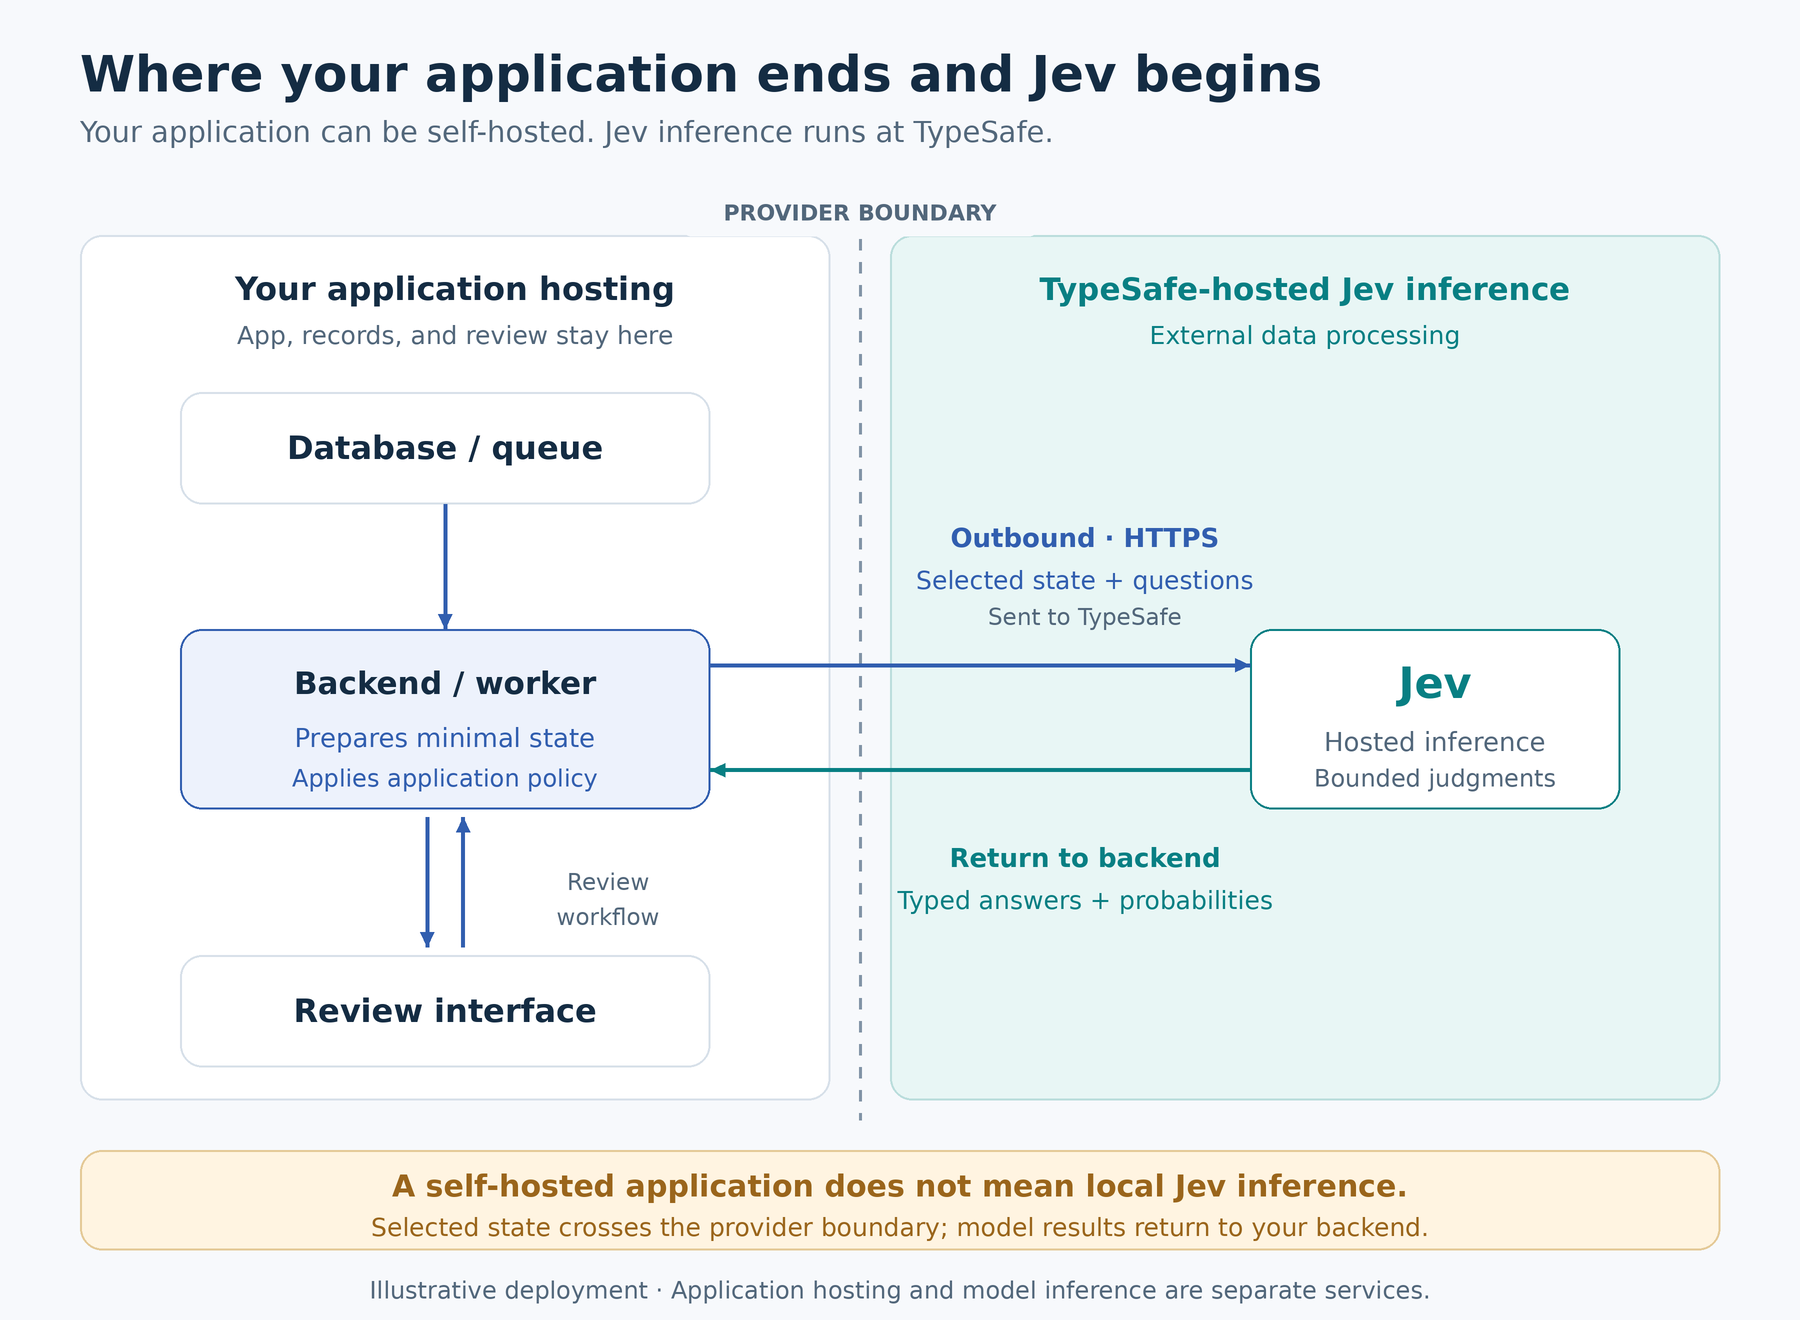
L’application, les enregistrements et l’interface d’examen peuvent s’exécuter sur votre serveur, tandis que le contexte sélectionné est transmis à TypeSafe pour l’inférence et les décisions reviennent au backend.
Avertissement — une application auto-hébergée ne signifie pas une inférence locale : L’état sélectionné quitte votre limite d’hébergement. Les engagements sans formation n’impliquent pas une rétention zéro par défaut. Vérifiez les conditions applicables du fournisseur avant d’envoyer des informations sensibles via ce flux de travail.
La politique de confidentialité de TypeSafe exclut l’entraînement ou le fine-tuning sur les entrées. Elle décrit également l’hébergement aux États-Unis et autorise la rétention si raisonnablement nécessaire. Son aperçu juridique offre une rétention zéro des données (ZDR) d’entreprise soumise aux conditions applicables. Pour les flux de travail de données personnelles, l’accord de traitement des données traite du traitement et des transferts internationaux ; l’emplacement du serveur n’est qu’une partie de la décision.
Envoyez uniquement le contexte nécessaire à la décision, en laissant de côté les secrets et les données personnelles inutiles. Protégez les clés du fournisseur et maintenez les contrôles d’accès en place. Conservez un fallback de délai d’expiration/limite de débit, comme la mise en file d’attente pour examen ; gérez les demandes échouées séparément des réponses incertaines. En tant qu’opérateur de l’application, vous restez responsable de la correction et de la surveillance. Les sauvegardes et la politique de flux de travail restent également de votre côté.
Qui devrait envisager Jev—et qui devrait l’ignorer ?
Jev apporte un jugement sémantique dans les logiciels par le biais de questions avec des réponses prédéfinies.
- Il peut router un message client
- Évaluer la pertinence d’un passage
- Estimer si une demande répond aux critères énoncés, en retournant des résultats typés et des probabilités que le code d’application peut utiliser.
Son attrait réside dans la rapidité et l’économie de ces décisions répétées. La valeur pratique dépend toujours de critères clairs, d’un contexte pertinent et de performances sur vos propres exemples. Les réponses contraintes peuvent être erronées, et les probabilités aident à guider l’examen plutôt qu’à garantir l’exactitude.
Pour le client demandant de « retourner le paiement supplémentaire », le rôle de Jev est de reconnaître la demande et d’aider à l’envoyer au bon endroit. Les enregistrements, les permissions et l’exécution du remboursement restent avec l’application. Commencez par un petit flux de travail vérifiable en utilisant l’API hébergée, puis mesurez la précision, les besoins de secours et le coût total. C’est là que la promesse de Jev devient concrète : un jugement utile connecté à une prochaine étape bien définie.